
Hold Semaphore tilgængelig, når en applikationsnode stopper
Placer aktive Semaphore-noder bag én tjenesteadresse. Hold brugerfladen og API'et tilgængelige under nodevedligeholdelse med fælles database og Redis-koordinering.
Din infrastruktur afhænger af, at automatiseringen er tilgængelig
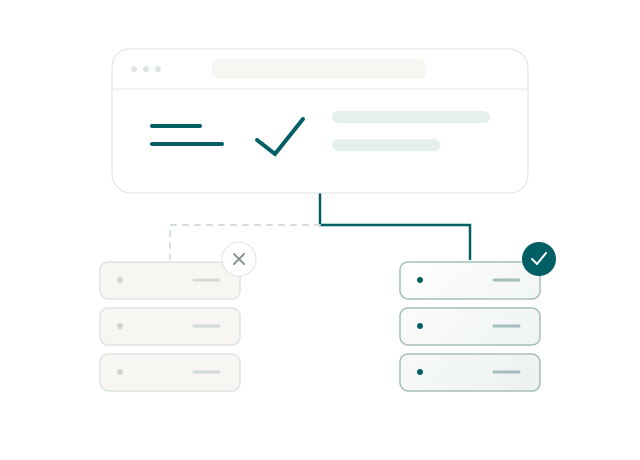
Under en hændelse har teamet brug for Semaphore til at køre gendannelsesjob og infrastrukturændringer. Én utilgængelig applikationsnode bør ikke fjerne den adgang.
Én applikationsnode offline
Åbn brugerfladen
Brug API'et
Start job
Hold Semaphore tilgængelig med Enterprise HA
Enterprise HA holder brugerfladen og API'et tilgængelige via raske applikationsnoder, når en anden node stopper.
En anden applikationsnode fortsætter med at betjene
Åbn brugerfladen
Brug API'et
Start job
Hvad Semaphore kræver til HA
01
To eller flere Semaphore-noder
Kør mindst to tilsvarende Semaphore-instanser. Hold fælles konfiguration ens, og giv hver node en unik ha.node_id.
02
HTTP- og WebSocket-belastningsfordeling
Diriger både HTTP- og WebSocket-forbindelser gennem en load balancer, der kan fjerne en usund node fra puljen.
03
Fælles SQL-database og Redis
Forbind hver node til samme PostgreSQL- eller MySQL-database og Redis-backend. Beskyt også disse fælles tjenester mod fejl. SQLite understøttes ikke til HA.
Se det optagede opgaveresultat fra den tilbageværende node →
Planlæg resten af produktionsinstallationen
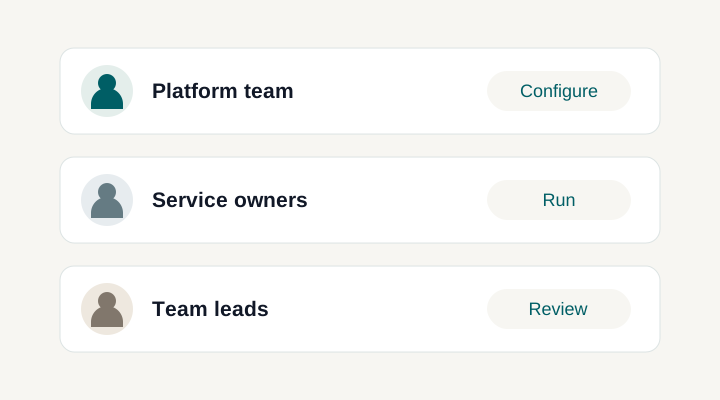
Giv teams den nødvendige adgang
AdgangskontrolPlanlæg tilgængelighed for hele installationen
Hold fælles tilstand synlig i arkitekturen
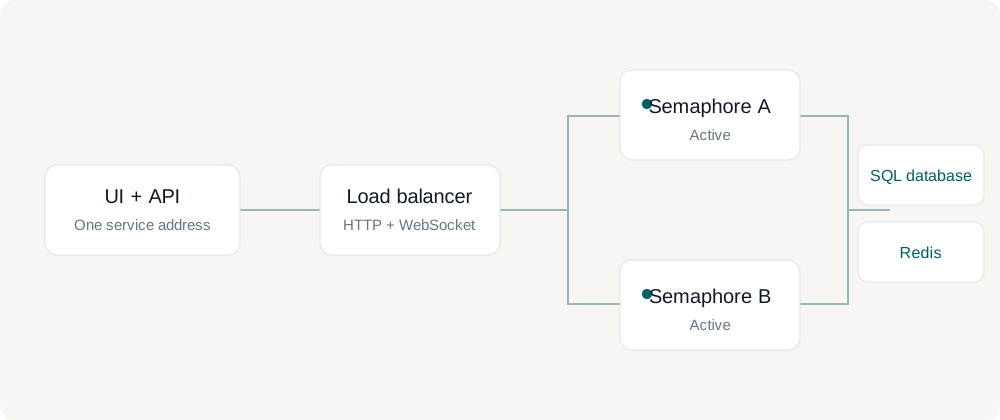
Den dokumenterede topologi er aktiv-aktiv: ligeværdige Semaphore-noder bruger én fælles PostgreSQL- eller MySQL-database og Redis-koordinering. Databasen holder applikationstilstanden; Redis understøtter distribuerede låse, køtilstand og opdateringer mellem noder. SQLite og BoltDB er ikke understøttede databasevalg i dette HA-design.
Understøt både anmodninger og liveopdateringer
Load balanceren skal håndtere HTTP- og WebSocket-trafik, så klienter når raske applikationsnoder og modtager liveopdateringer. Dens egen redundans, TLS-konfiguration, tilstandskontroller og driftsadfærd hører til installationen. Tilføjelse af applikationsnoder konfigurerer ikke disse egenskaber automatisk.
Skaler applikations- og eksekveringsveje separat
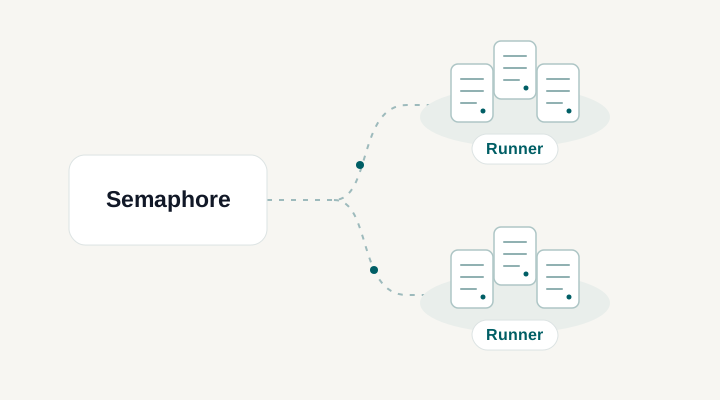
Applikationsnoder leverer web/API- og koordinationslaget. Runnere kan placere og udvide opgaveeksekveringen uafhængigt. Det hjælper teamet med at afgøre, om en kapacitetsændring vedrører bruger/API-belastning, samtidige opgaver eller adgang til et andet netværk, frem for at antage, at enhver ekstra applikationsnode løser alle tre problemer.
Giv hvert fejldomæne sin egen gendannelsesplan
Tilgængelighed af applikationsnoder, databasegendannelse, Redis-tilgængelighed og katastrofegendannelse for hele miljøet er forskellige ansvarsområder. Sikkerhedskopier, gendannelsestest, gendannelsesmål og versionskompatible opgraderingsprocedurer er stadig nødvendige. En topologi kan tåle én type fejl og stadig være sårbar over for en anden.
Hold koordinering tilgængelig med Redis Sentinel
Brug Redis Sentinel-backenden, når koordinering også kræver failover. Hver Semaphore-node finder den aktive Redis-master via Sentinel og følger en forfremmet replika uden genstart. Konfigurer samme Sentinel-installation på applikationsnoderne sammen med planen for fælles database og load balancer-tilgængelighed.
Inkluder fælles afhængigheder i tilgængelighedsplanen
SQL-databasen, Redis og load balanceren betjener alle applikationsnoder. Konfigurer redundans og gendannelse for disse tjenester sammen med Semaphore-noderne.
Bevar en gendannelsesvej for dataene
Applikationsredundans og datagendannelse løser forskellige problemer. Vedligehold sikkerhedskopier, og test gendannelse af den database og konfiguration, som automatiseringen afhænger af.
Dokumentation og relaterede funktioner
FAQ
Hvilke komponenter kræves til Semaphore høj tilgængelighed?
Den dokumenterede aktiv-aktiv-arkitektur bruger flere Semaphore-applikationsnoder, en fælles PostgreSQL- eller MySQL-database, Redis-koordinering og en load balancer med HTTP- og WebSocket-understøttelse. Hver node kræver passende fælles indstillinger og en unik HA-identifikator. Planlæg afhængighedernes tilgængelighed sammen med applikationsnoderne. En anden proces alene giver ikke den fælles tilstand og koordinering, hele topologien kræver.
Er Semaphore HA aktiv-aktiv eller aktiv-passiv?
Arkitekturen her er aktiv-aktiv med ligeværdige applikationsnoder, der deltager i tjenesten. Den afhænger ikke af en dedikeret primær applikationsnode og en passiv reserve. Brug den aktuelle HA-vejledning til det understøttede design, og udled ikke en separat aktiv-passiv referencearkitektur af generelle tilgængelighedsformuleringer. Afklar tilstands- og failoveradfærd før installation, hvis infrastrukturen kræver en anden topologi.
Kan jeg bruge SQLite eller BoltDB i en HA-installation?
Nej. Det dokumenterede HA-design kræver en fælles PostgreSQL- eller MySQL-database sammen med Redis. Databasen er den fælles kilde til applikationstilstand for de deltagende noder. Planlæg migrering, sikkerhedskopier og validering separat, hvis du kommer fra én node med anden lagring. Tilføjelse af applikationsnoder bør ikke være første test af, at den fælles database indeholder og leverer de nødvendige data.
Beskytter applikations-HA også databasen, Redis og load balanceren?
Disse komponenter kræver egen robusthedsstrategi. Semaphores fler-nodedesign opretter ikke automatisk databasefailover, redundant belastningsfordeling eller en tilgængelig Redis-tjeneste. Identificer hver afhængigheds fejldomæne, gendannelsesproces og kapacitetskrav. Test hele vejen fra klientanmodning til opgaveresultat, så tilgængelighedsplanen dækker tjenesten, folk bruger, frem for kun antallet af kørende applikationsnoder.
Overlever kørende opgaver en applikationsnodefejl eller opgradering?
Antag ikke uafbrudt igangværende eksekvering, blot fordi der er flere applikationsnoder. Adfærden afhænger af eksekveringsforløbet, den fejlramte komponent og den anvendte version. Test den opgavelivscyklus, du er afhængig af, herunder statusrapportering og runnerens deltagelse. Planlæg også opgraderingskompatibilitet og migrering bevidst frem for at se enhver versionsændring som en garanteret rullende opgradering uden nedetid. Tilgængelighed af brugerfladen og kontinuitet af opgaver er forskellige krav.
Hvilken plan indeholder HA, og hvordan bør vi vurdere den?
Høj tilgængelighed er en Enterprise-funktion. Begynd med nødvendige driftstider, vedligeholdelsesproces, gendannelsesmål og eksisterende database- og load balancer-tjenester. Brug den dokumenterede topologi til at finde mangler, og test derefter nodefjernelse, gendannelse af afhængigheder og sikkerhedskopier i et repræsentativt miljø. En arkitektursamtale er nyttig, når kravene er forretningskritiske, fordi hele installationen, ikke en enkelt funktionskontakt, bestemmer resultatet.
Kan brugere beholde samme URL, når en applikationsnode tages offline?
Det er formålet med at placere aktive applikationsnoder bag én belastningsfordelt tjenesteadresse. Load balanceren skal stoppe med at sende anmodninger til den utilgængelige node og understøtte både HTTP og WebSocket. Den tilbageværende node kræver stadig adgang til fælles database, Redis og ens applikationskonfiguration for at betjene projektet.
Har jeg brug for HA for at udføre opgaver i flere private netværk?
Nej. Flere eksekveringsplaceringer håndteres af runnere. Høj tilgængelighed handler om Semaphore-applikationslaget, mens runnere handler om opgaveplacering og tilgængelige systemer. En produktionsinstallation kan bruge begge: HA-applikationsnoder til fælles brugerflade og API samt projektrunnere nær privat infrastruktur.