
Semaphore bei Ausfall eines Anwendungsknotens verfügbar halten
Betreiben Sie aktive Semaphore-Knoten unter einer gemeinsamen Dienstadresse. Halten Sie Oberfläche und API während der Wartung von Anwendungsknoten erreichbar, mit gemeinsamer Datenbank und Redis-Koordination.
Ihre Infrastruktur benötigt verfügbare Automatisierung
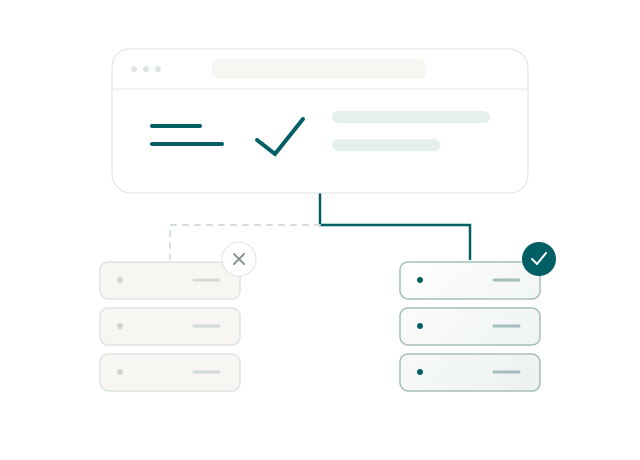
Bei einem Vorfall benötigt Ihr Team Semaphore für Wiederherstellungsjobs und Infrastrukturänderungen. Ein ausgefallener Anwendungsknoten sollte diesen Zugriff nicht verhindern.
Ein Anwendungsknoten offline
Oberfläche öffnen
API verwenden
Jobs starten
Semaphore mit Enterprise HA verfügbar halten
Enterprise HA hält Oberfläche und API über funktionsfähige Anwendungsknoten verfügbar, wenn ein anderer Knoten ausfällt.
Ein weiterer Anwendungsknoten bedient weiter Anfragen
Oberfläche öffnen
API verwenden
Jobs starten
Was Semaphore für HA benötigt
01
Zwei oder mehr Semaphore-Knoten
Betreiben Sie mindestens zwei gleichwertige Semaphore-Instanzen. Halten Sie die gemeinsame Konfiguration synchron und geben Sie jedem Knoten eine eindeutige ha.node_id.
02
HTTP- und WebSocket-Lastverteilung
Leiten Sie HTTP- und WebSocket-Verbindungen über einen Load Balancer, der fehlerhafte Knoten aus seinem Pool entfernen kann.
03
Gemeinsame SQL-Datenbank und Redis
Verbinden Sie jeden Knoten mit derselben PostgreSQL- oder MySQL-Datenbank und demselben Redis-Backend. Schützen Sie auch diese gemeinsamen Dienste vor Ausfällen. SQLite wird für HA nicht unterstützt.
Das aufgezeichnete Task-Ergebnis vom verbleibenden Knoten ansehen →
Die übrige Produktionsbereitstellung planen
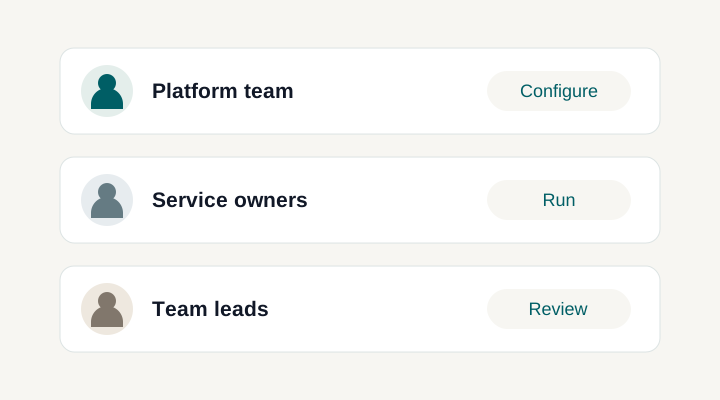
Teams den benötigten Zugriff geben
ZugriffskontrolleVerfügbarkeit für die gesamte Bereitstellung planen
Gemeinsamen Zustand in der Architektur sichtbar halten
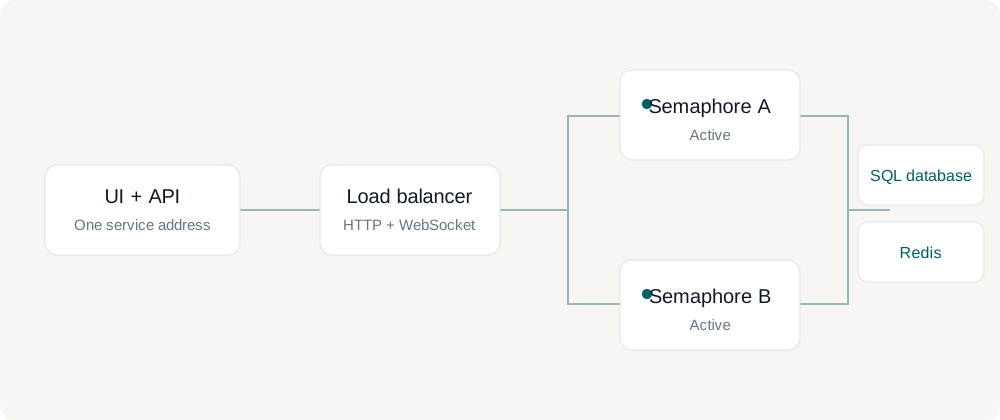
Die dokumentierte Topologie ist aktiv/aktiv: Gleichwertige Semaphore-Knoten verwenden eine gemeinsame PostgreSQL- oder MySQL-Datenbank und Redis-Koordination. Die Datenbank hält den Anwendungszustand; Redis unterstützt verteilte Sperren, Warteschlangenzustand und Aktualisierungen zwischen Knoten. SQLite und BoltDB sind für dieses HA-Konzept keine unterstützten Datenbanken.
Anfragen und Live-Aktualisierungen unterstützen
Der Load Balancer muss HTTP- und WebSocket-Verkehr verarbeiten, damit Clients funktionsfähige Anwendungsknoten erreichen und Live-Aktualisierungen erhalten. Seine eigene Redundanz, TLS-Konfiguration, Zustandsprüfungen und sein Betriebsverhalten gehören zur Bereitstellung. Zusätzliche Anwendungsknoten konfigurieren diese Eigenschaften nicht automatisch.
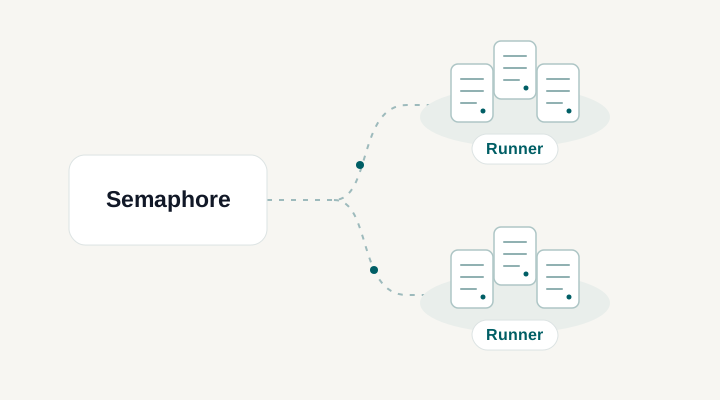
Anwendungs- und Ausführungswege getrennt skalieren
Anwendungsknoten stellen Weboberfläche, API und Koordination bereit. Runner können die Aufgabenausführung unabhängig davon verlagern und erweitern. So kann das Team unterscheiden, ob eine Kapazitätsänderung Benutzer- und API-Last, parallele Aufgaben oder den Zugang zu einem weiteren Netzwerk betrifft, statt anzunehmen, jeder zusätzliche Anwendungsknoten löse alle drei Probleme.
Für jeden Ausfallbereich einen eigenen Wiederherstellungsplan erstellen
Verfügbarkeit der Anwendungsknoten, Datenbankwiederherstellung, Redis-Verfügbarkeit und standortübergreifende Notfallwiederherstellung sind unterschiedliche Verantwortungsbereiche. Backups, Wiederherstellungstests, Wiederherstellungsziele und versionskompatible Upgrade-Verfahren bleiben notwendig. Eine Topologie kann einen bestimmten Ausfall verkraften und zugleich gegenüber einem anderen anfällig bleiben.
Koordination mit Redis Sentinel verfügbar halten
Nutzen Sie das Redis-Sentinel-Backend, wenn auch die Koordination Failover benötigt. Jeder Semaphore-Knoten ermittelt über Sentinel den aktiven Redis-Master und folgt einer hochgestuften Replik ohne Neustart. Konfigurieren Sie dieselbe Sentinel-Bereitstellung auf allen Anwendungsknoten, zusammen mit der Verfügbarkeitsplanung für gemeinsame Datenbank und Load Balancer.
Gemeinsame Abhängigkeiten in die Verfügbarkeitsplanung einbeziehen
SQL-Datenbank, Redis und Load Balancer dienen allen Anwendungsknoten. Konfigurieren Sie Redundanz und Wiederherstellung für diese Dienste zusammen mit den Semaphore-Knoten.
Einen Wiederherstellungsweg für die Daten bereithalten
Anwendungsredundanz und Datenwiederherstellung lösen unterschiedliche Probleme. Sichern Sie die Datenbank und Konfiguration, von denen Ihre Automatisierung abhängt, und testen Sie deren Wiederherstellung.
Dokumentation und verwandte Funktionen
FAQ
Welche Komponenten werden für Semaphore-Hochverfügbarkeit benötigt?
Die dokumentierte aktiv/aktiv-Architektur verwendet mehrere Semaphore-Anwendungsknoten, eine gemeinsame PostgreSQL- oder MySQL-Datenbank, Redis-Koordination und einen Load Balancer für HTTP- und WebSocket-Verkehr. Jeder Knoten benötigt passende gemeinsame Einstellungen und eine eindeutige HA-Kennung. Planen Sie die Verfügbarkeit dieser Abhängigkeiten zusammen mit den Anwendungsknoten. Ein zweiter Prozess allein stellt nicht den gemeinsamen Zustand und die Koordination der vollständigen Topologie bereit.
Ist Semaphore HA aktiv/aktiv oder aktiv/passiv?
Die hier beschriebene Architektur ist aktiv/aktiv: Gleichwertige Anwendungsknoten beteiligen sich am Dienst. Sie benötigt keinen dedizierten primären Anwendungsknoten und keinen passiven Ersatzknoten. Konfigurieren Sie das unterstützte Konzept anhand der aktuellen HA-Anleitung und leiten Sie aus allgemeinen Verfügbarkeitsaussagen keine separate aktiv/passiv-Referenzarchitektur ab. Benötigt Ihre Infrastruktur eine andere Topologie, klären Sie deren Zustands- und Failover-Verhalten vor der Bereitstellung.
Kann ich SQLite oder BoltDB in einer HA-Bereitstellung verwenden?
Nein. Das dokumentierte HA-Konzept benötigt eine gemeinsame PostgreSQL- oder MySQL-Datenbank zusammen mit Redis. Die Datenbank ist die gemeinsame Quelle des Anwendungszustands für die beteiligten Knoten. Wenn Sie von einer Einzelknoteninstallation mit einer anderen Speicheroption wechseln, planen Sie Migration, Sicherungen und Validierung als eigene Arbeit. Testen Sie bereits vor dem Hinzufügen von Anwendungsknoten, dass die vorgesehene gemeinsame Datenbank die benötigten Daten enthält und bereitstellt.
Schützt die Hochverfügbarkeit der Anwendung auch Datenbank, Redis und Load Balancer?
Diese Komponenten benötigen eine eigene Ausfallsicherheitsstrategie. Das Mehrknotenkonzept von Semaphore erzeugt nicht automatisch Datenbank-Failover, redundante Lastverteilung oder einen verfügbaren Redis-Dienst. Ermitteln Sie Ausfallbereich, Wiederherstellungsprozess und Kapazitätsanforderungen jeder Abhängigkeit. Testen Sie den gesamten Weg von der Client-Anfrage bis zum Task-Ergebnis, damit Ihr Verfügbarkeitsplan den tatsächlich genutzten Dienst abdeckt und nicht nur die Anzahl laufender Anwendungsknoten.
Überstehen laufende Tasks einen Anwendungsknotenausfall oder ein Upgrade?
Leiten Sie aus mehreren Anwendungsknoten keine unterbrechungsfreie Fortsetzung laufender Tasks ab. Das Verhalten hängt vom Ausführungsweg, der ausgefallenen Komponente und der eingesetzten Version ab. Testen Sie den benötigten Task-Lebenszyklus einschließlich Statusmeldungen und beteiligter Runner. Planen Sie auch Versionskompatibilität und Migrationen bewusst, statt jede Aktualisierung als garantiert unterbrechungsfreies Rolling-Update zu behandeln. Verfügbarkeit der Oberfläche und Fortsetzung von Tasks sind unterschiedliche Anforderungen.
Welcher Tarif enthält HA und wie sollten wir es bewerten?
Hochverfügbarkeit ist eine Enterprise-Funktion. Beginnen Sie mit Ihren erforderlichen Betriebszeiten, Wartungsabläufen, Wiederherstellungszielen sowie vorhandenen Datenbank- und Load-Balancer-Diensten. Ermitteln Sie Lücken anhand der dokumentierten Topologie und testen Sie Knotenausfälle, die Wiederherstellung von Abhängigkeiten und Sicherungen in einer repräsentativen Umgebung. Bei geschäftskritischen Anforderungen ist eine Architekturabstimmung sinnvoll, da die gesamte Bereitstellung das Ergebnis bestimmt, nicht ein einzelner Funktionsschalter.
Können Benutzer dieselbe URL weiterverwenden, wenn ein Anwendungsknoten abgeschaltet wird?
Dazu werden aktive Anwendungsknoten hinter einer gemeinsamen, lastverteilten Dienstadresse betrieben. Der Load Balancer muss Anfragen an den ausgefallenen Knoten einstellen und HTTP- sowie WebSocket-Verkehr unterstützen. Der verbleibende Knoten benötigt weiterhin Zugriff auf die gemeinsame Datenbank, Redis und eine übereinstimmende Anwendungskonfiguration, um das Projekt bereitzustellen.
Brauche ich HA, um Aufgaben in mehreren privaten Netzwerken auszuführen?
Nein. Mehrere Ausführungsstandorte werden durch Runner abgedeckt. Hochverfügbarkeit betrifft die Semaphore-Anwendungsebene; Runner bestimmen Ausführungsort und erreichbare Systeme. Eine Produktionsbereitstellung kann beides nutzen: HA-Anwendungsknoten für gemeinsame Oberfläche und API sowie Projekt-Runner nahe privater Infrastruktur.