Python-Automatisierung über den eigenen Laptop hinaus ausführen

Machen Sie Python-Prüfungen, Berichte und API-Integrationen zu gemeinsamen Semaphore-Jobs. Halten Sie Code in Git, übergeben Sie wiederverwendbare Eingaben und planen Sie Skripte mit einem Ergebnis für jede Ausführung.

Das Skript läuft auf Ihrem Laptop. Kann das Team es ausführen?

Lokale Pakete, Umgebungswerte und ein nur im Gedächtnis gespeicherter Befehl erschweren es, ein nützliches Python-Skript zu übergeben oder täglich zuverlässig auszuführen.

Dem Skript eine wiederholbare Ausführungsumgebung geben

  • Repository und .py-Einstiegspunkt speichern
  • Python-Pakete in der Ausführungsumgebung einrichten
  • Bei Bedarf oder nach Zeitplan mit gemeinsamer Ausgabe ausführen

Ihre Python-Bibliotheken für betriebliche Arbeit verwenden

Konfiguration vor einer Änderung validieren

Führen Sie Ihre Schema- oder Richtlinienprüfungen für Konfiguration aus Git aus. Beenden Sie den Task bei fehlgeschlagener Validierung mit einem Fehlercode, bevor ein weiterer Workflow-Schritt Infrastruktur ändert.

Einem Workflow einen Prüfschritt hinzufügen

CMDB oder Dienstkatalog synchronisieren

Führen Sie Ihr API-Integrationsskript mit wiederverwendbaren Umgebungseingaben aus. Planen Sie die Synchronisierung, damit das Team sie nicht von Hand starten muss.

Einen Integrationsjob planen

Dienste nach einer Bereitstellung prüfen

Prüfen Sie mit Ihren Python-Bibliotheken Endpunkte und Anwendungsbereitschaft nach Terraform- oder Ansible-Jobs. Halten Sie das Ergebnis beim gesamten Vorgang.

Deployment und Prüfung verbinden

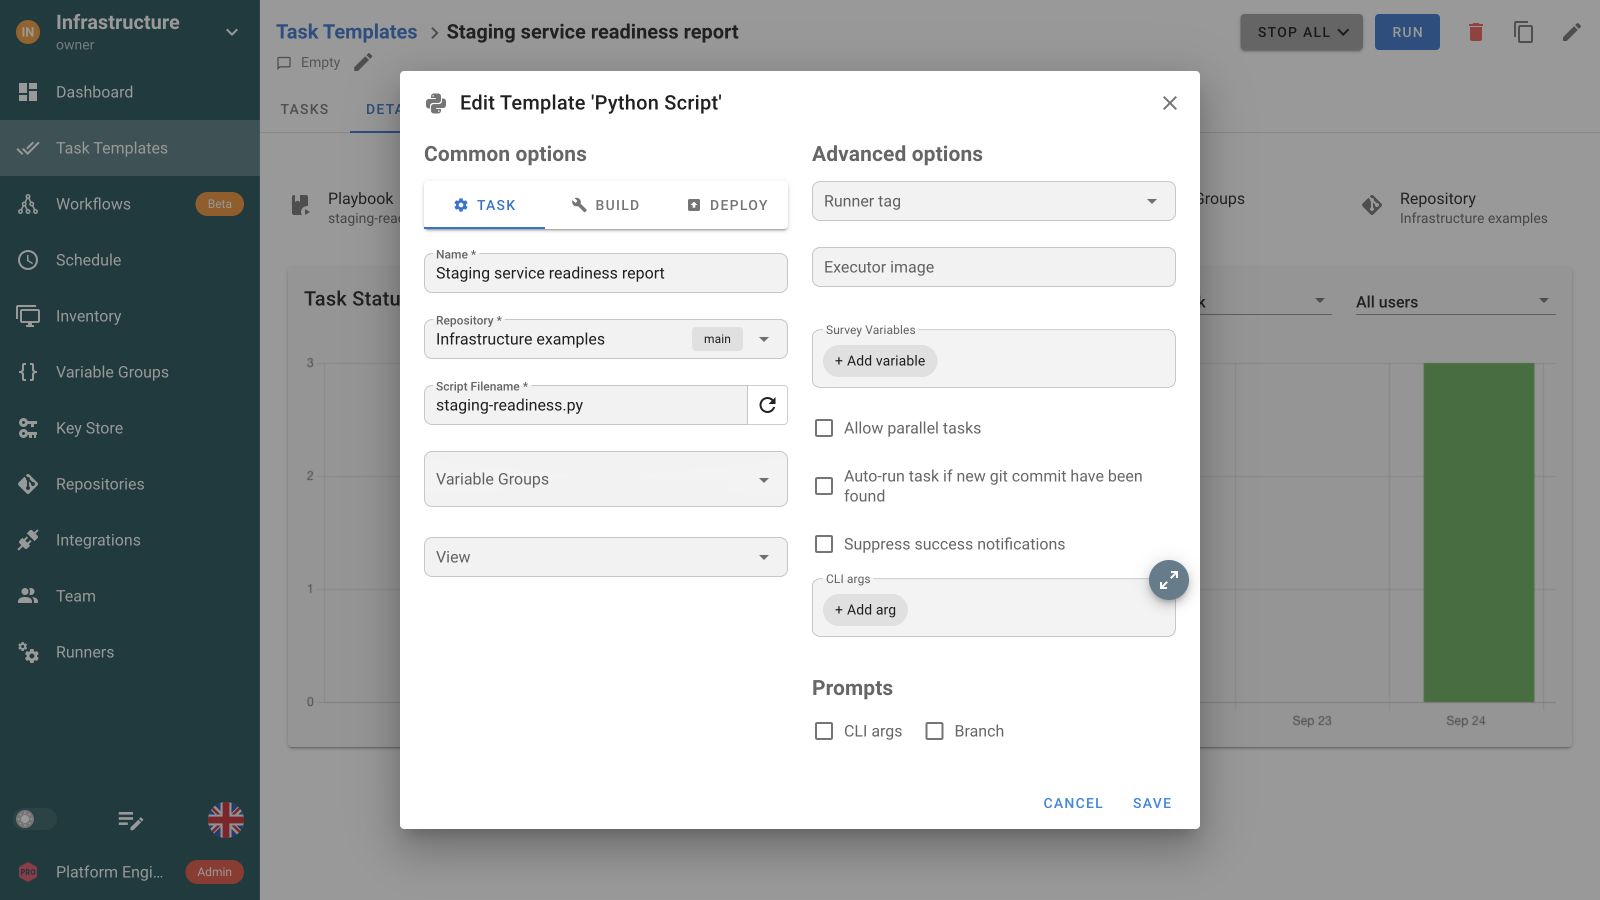
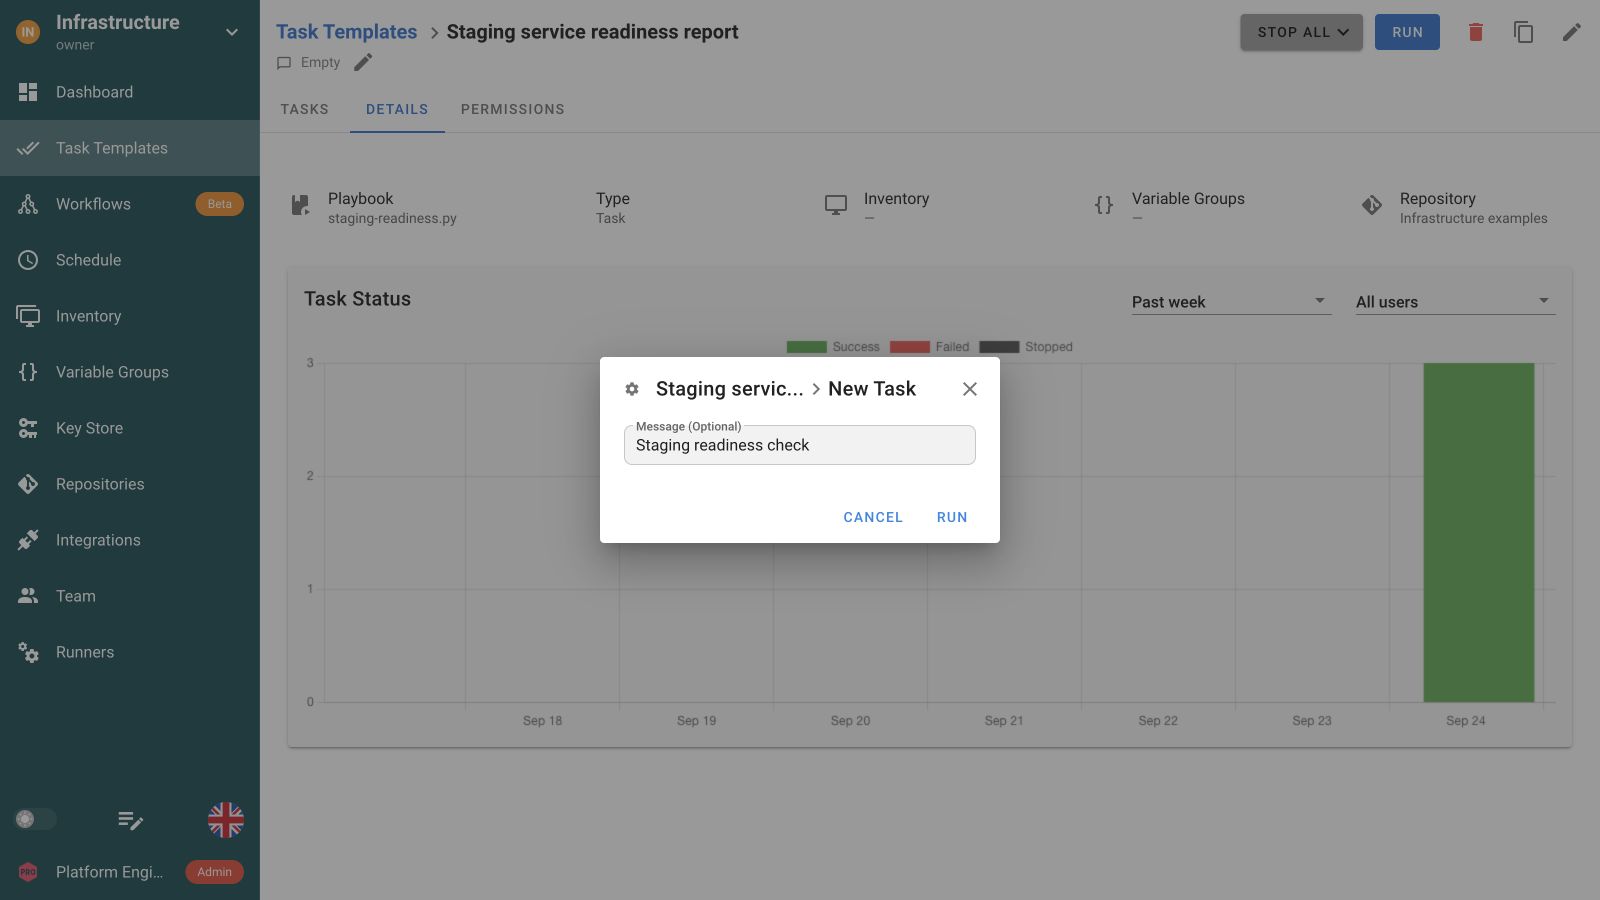
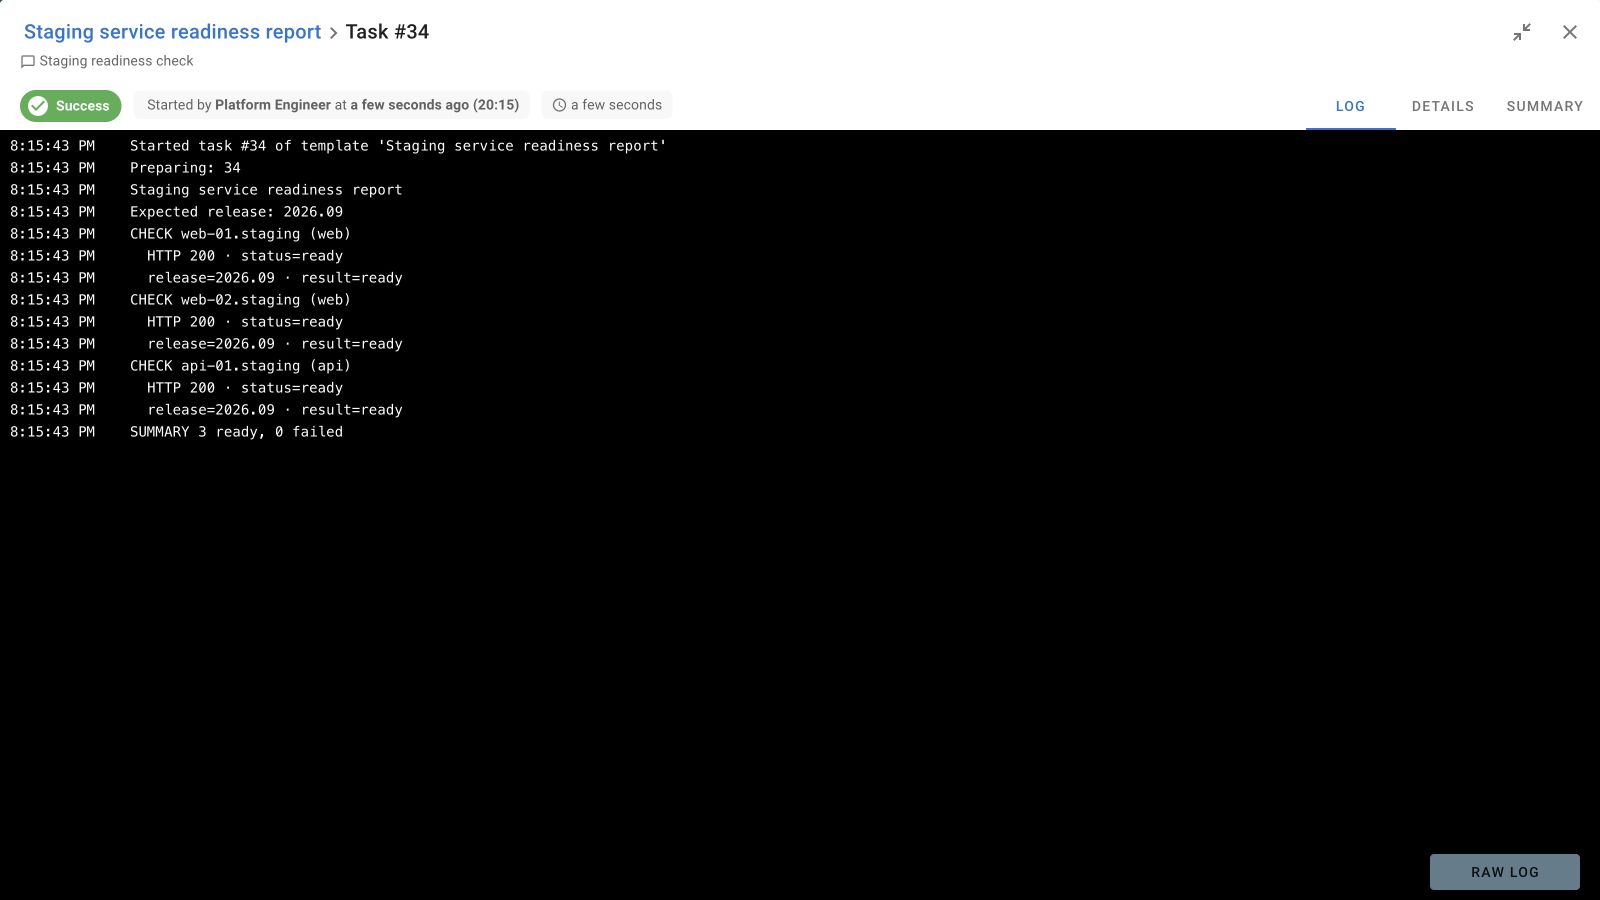
Einen Python-Job speichern, starten und die Ausgabe lesen

Konfiguration vor Infrastrukturänderungen validieren

Führen Sie zuerst Ihren Python-Validator aus. Setzen Sie erst nach erfolgreicher Validierung mit Terraform fort und konfigurieren Sie die Umgebung anschließend mit Ansible. Jeder Schritt behält seine eigene Ausgabe.

KonfigurationsprüfungWorkflow
Konfiguration validieren
Bei ErfolgAusgaben → Eingaben
Infrastruktur bereitstellen
Bei ErfolgAusgaben → Eingaben
Die Umgebung konfigurieren
Bei Fehler
Diagnosedaten sammeln

Python-Code, Abhängigkeiten und Eingaben

Interpreter und Pakete einrichten

Python-Tasks verwenden python3 in der Ausführungsumgebung. Installieren Sie dort die Abhängigkeiten Ihres Skripts. Die Docker-Installation unterstützt eine requirements.txt unter /etc/semaphore/requirements.txt, die beim Containerstart installiert wird.

Wiederverwendbare Konfiguration und Geheimnisse bereitstellen

Variable Groups übergeben Umgebungsvariablen, die Ihr Skript über os.environ lesen kann. Speichern Sie sensible Werte in geheimen Einträgen, statt sie in den Quelltext einzubetten.

Ausgaben aufbewahren und Berichte bewusst speichern

Semaphore speichert Task-Status und Ausgabe. Ihr Skript sollte bei einem Fehler einen von null verschiedenen Exit-Code zurückgeben. Speichern Sie erzeugte Dateien im Speicher Ihres Prozesses, statt Task-Logs als Dateispeicher zu behandeln.

Die vom Code benötigte Umgebung wählen

Führen Sie auf einem vorbereiteten Server aus oder verwenden Sie Projekt-Runner in Pro für dedizierte Umgebungen. Halten Sie Python-Version, Pakete und Zugriff auf externe APIs über Ausführungen hinweg einheitlich.

FAQ

Welcher Python-Interpreter führt einen Semaphore-Python-Task aus?

Python-Tasks verwenden python3 in der Ausführungsumgebung. Richten Sie dort die Python-Version und die von Ihrem Skript importierten Pakete ein. Ein Task Template wählt Repository und .py-Pfad; Server oder Runner stellen Laufzeitumgebung und Netzwerkzugriff bereit.

Werden Python-Abhängigkeiten für jede Aufgabe automatisch installiert?

Richten Sie die benötigten Pakete in der Ausführungsumgebung ein. Bei der Docker-Installation wird eine unter /etc/semaphore/requirements.txt eingebundene requirements.txt beim Containerstart installiert. Das erzeugt weder für jeden Task eine neue virtuelle Umgebung noch installiert es jeweils die Abhängigkeiten des Repositories.

Wie kann ein Python-Skript Parameter und Zugangsdaten erhalten?

Verknüpfen Sie Variable Groups mit dem Task Template. Ihre Werte werden zu Umgebungsvariablen, die Python über os.environ lesen kann. Speichern Sie sensible Werte als Secrets statt im Quellcode. Prüfen Sie Laufzeiteingaben, bevor Sie sie in API-Anfragen oder Dateipfaden verwenden.

Wo sollte ein erzeugter CSV- oder JSON-Bericht gespeichert werden?

Lassen Sie Ihr Skript Berichte in einem von Ihrem Prozess verwendeten dauerhaften Speicher ablegen, etwa einem Objektspeicher oder einem gemeinsamen Ziel. Geben Sie in der Task-Ausgabe einen hilfreichen Verweis aus. Die Semaphore-Task-Historie bewahrt Status und Logs auf und dient nicht als allgemeines Dateiarchiv.

Kann ich Konfigurationen vor dem Deployment mit Python prüfen?

Ja. Prüfen Sie Konfiguration mit Ihrem eigenen Validierungsskript und Ihren Bibliotheken und geben Sie bei einer fehlgeschlagenen Prüfung einen von null verschiedenen Exit-Code zurück. Platzieren Sie dieses Task Template in einem Workflow vor Terraform oder Ansible. Semaphore koordiniert die Tasks, statt einen integrierten Validator bereitzustellen.

Kann ich eine Python-Inventarsynchronisierung oder einen Bericht zeitlich planen?

Ja. Erstellen Sie ein Python Task Template mit Skript, Umgebungseingaben und erforderlichen Paketen und ergänzen Sie einen Zeitplan. Ihr Code führt API-Synchronisierung oder Berichtserstellung aus. Semaphore erfasst jede Ausführung und kann Benachrichtigungen für konfigurierte Task-Ergebnisse senden.

Können Python-Prüfungen nach Ansible oder Terraform laufen?

Ja. Fügen Sie das Python Task Template nach dem Bereitstellungs- oder Konfigurationsschritt in einem Workflow ein. Prüfen Sie damit Anwendungsbereitschaft oder eine andere durch Ihr Skript prüfbare Bedingung. Der Exit-Status des Tasks bestimmt, ob sein konfigurierter Erfolgs- oder Fehlerpfad folgt.

Kann mein Team Python-Jobs ausführen, ohne Python lokal zu installieren?

Ja. Python und seine Pakete laufen in der Ausführungsumgebung von Semaphore. Teammitglieder nutzen den gespeicherten Job über Oberfläche oder API und prüfen seine Ausgabe. Konfigurieren Sie Projektrollen und Vorlageneingaben so, dass sie den Vorgang mit dem benötigten Zugriff ausführen können.