Exécuter l’automatisation Python au-delà de votre ordinateur

Transformez vérifications Python, rapports et intégrations API en travaux Semaphore partagés. Gardez le code dans Git, transmettez des entrées réutilisables et planifiez les scripts avec un résultat par exécution.

Le script fonctionne sur votre ordinateur. L’équipe peut-elle l’exécuter ?

Paquets locaux, valeurs d’environnement et commande mémorisée rendent un script Python utile difficile à transmettre ou à exécuter fiablement chaque jour.

Donner au script une configuration d’exécution reproductible

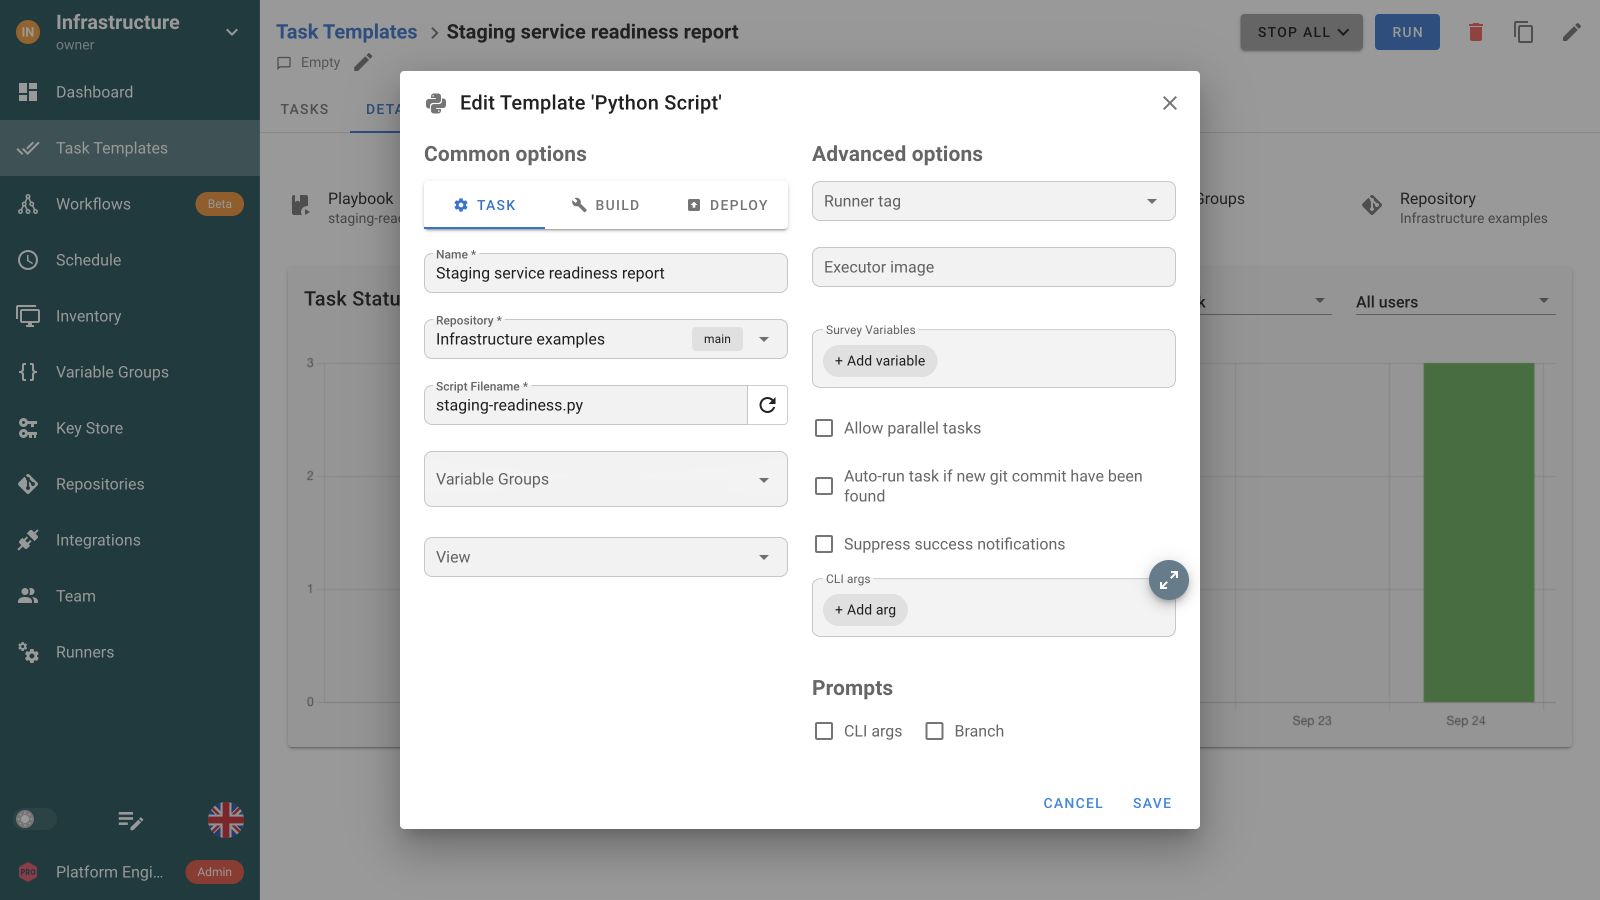
  • Enregistrer le dépôt et le point d’entrée .py
  • Préparer les paquets Python dans l’environnement d’exécution
  • Exécuter à la demande ou selon une planification avec sortie partagée

Utiliser vos bibliothèques Python pour les opérations

Valider la configuration avant un changement

Exécutez vos vérifications de schéma ou de règles sur la configuration issue de Git. En cas de validation échouée, arrêtez la tâche avec un code d’échec avant qu’une autre étape du workflow ne modifie l’infrastructure.

Ajouter une étape de validation à un workflow

Synchroniser votre CMDB ou catalogue de services

Exécutez votre script d’intégration API avec des entrées d’environnement réutilisables. Planifiez la synchronisation pour éviter un démarrage manuel par l’équipe.

Planifier un travail d’intégration

Vérifier les services après un déploiement

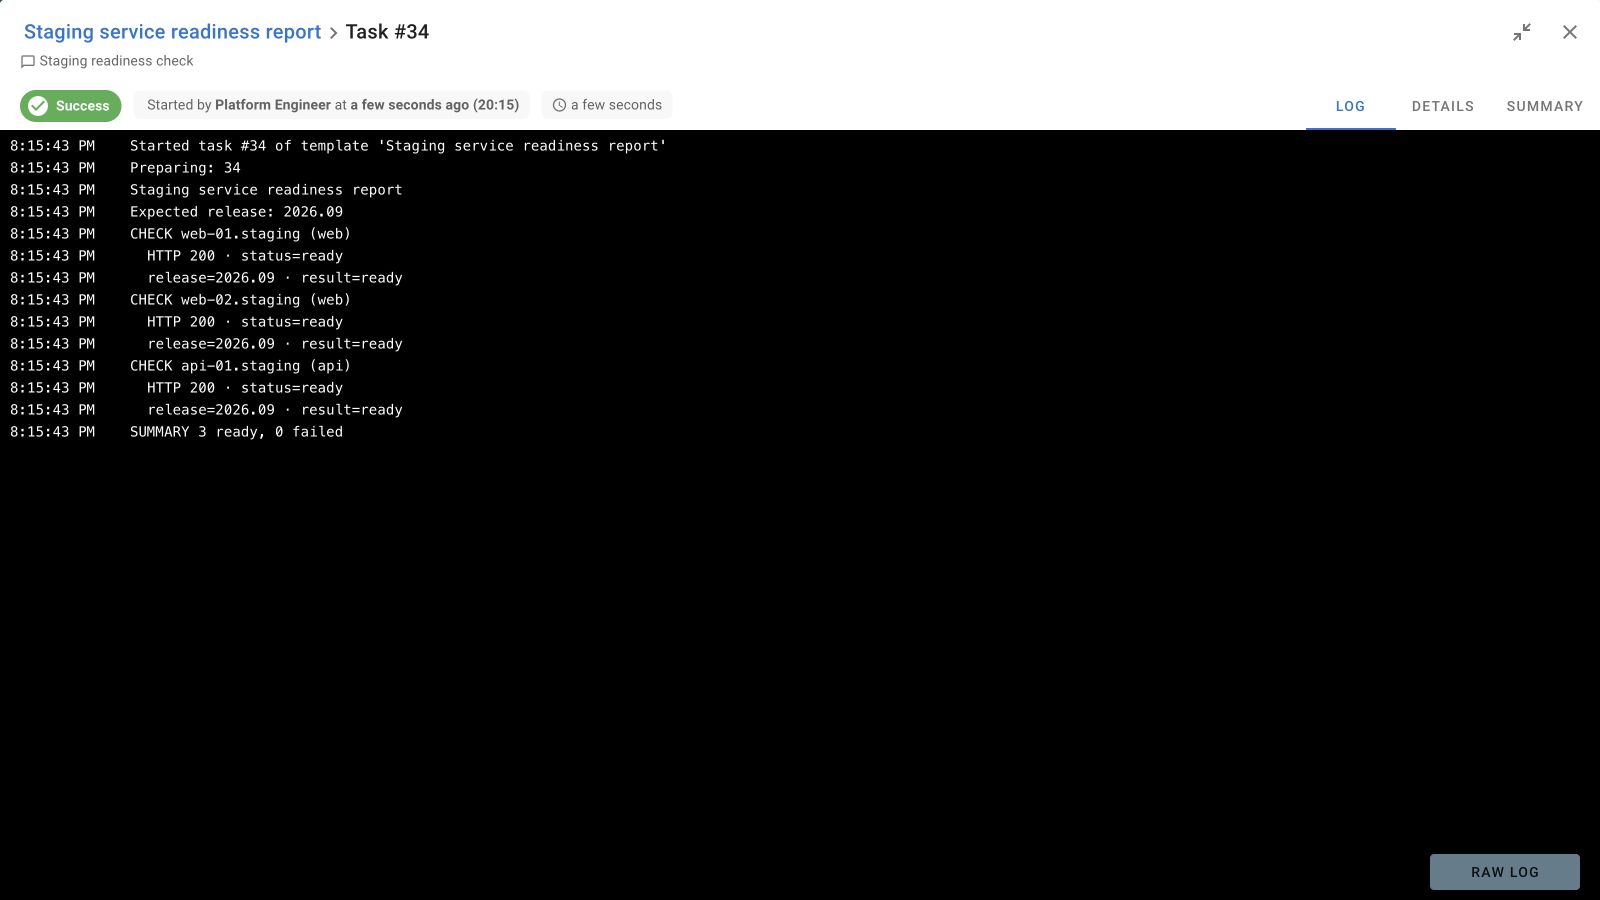
Utilisez vos bibliothèques Python pour vérifier points de terminaison et disponibilité applicative après Terraform ou Ansible. Gardez le résultat avec l’opération complète.

Relier déploiement et vérification

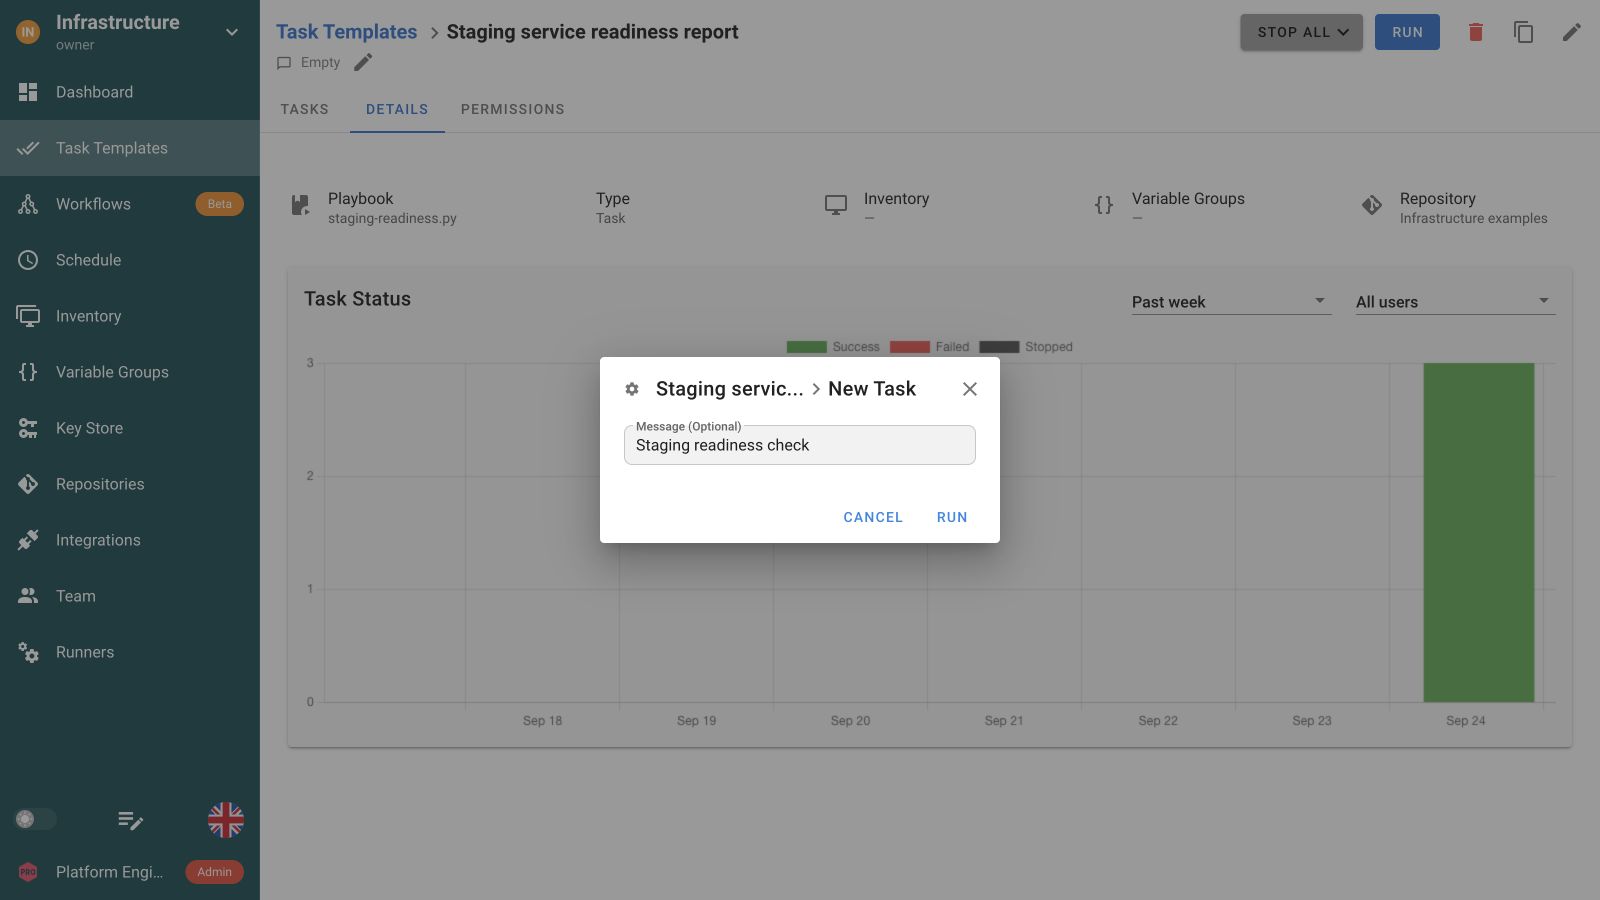
Enregistrer un travail Python, le lancer et lire la sortie

Valider la configuration avant les modifications d’infrastructure

Exécutez d’abord votre validateur Python. Passez à Terraform uniquement après validation réussie, puis configurez l’environnement avec Ansible. Chaque étape garde sa sortie.

Validation de la configurationWorkflow
Valider la configuration
En cas de réussiteSorties → entrées
Provisionner l’infrastructure
En cas de réussiteSorties → entrées
Configurer l’environnement
En cas d’échec
Collecter les diagnostics

Code Python, dépendances et entrées

Préparer l’interpréteur et les paquets

Les tâches Python utilisent python3 dans l’environnement d’exécution. Installez-y les dépendances du script. L’installation Docker prend en charge un fichier requirements.txt dans /etc/semaphore/requirements.txt, installé au démarrage du conteneur.

Fournir configuration réutilisable et secrets

Les Variable Groups injectent des variables d’environnement lisibles par le script via os.environ. Gardez les valeurs sensibles dans des entrées secrètes plutôt que dans le code.

Conserver les sorties et stocker les rapports délibérément

Semaphore conserve état et sortie des tâches. Votre script doit renvoyer un code non nul en cas d’échec. Enregistrez les fichiers générés dans le stockage de votre processus plutôt que d’utiliser les journaux comme dépôt de fichiers.

Choisir l’environnement nécessaire à votre code

Exécutez sur un serveur préparé ou utilisez les runners de projet Pro pour des environnements dédiés. Gardez version Python, paquets et accès aux API externes cohérents entre exécutions.

FAQ

Quel interpréteur Python exécute une tâche Python Semaphore ?

Les tâches Python utilisent python3 dans l’environnement d’exécution. Préparez-y la version Python et les paquets importés par le script. Un Task Template choisit le dépôt et le chemin .py, tandis que le serveur ou runner fournit l’environnement et l’accès réseau.

Les dépendances Python sont-elles installées automatiquement pour chaque tâche ?

Préparez les paquets requis dans l’environnement d’exécution. Pour l’installation Docker, un fichier requirements.txt monté dans /etc/semaphore/requirements.txt est installé au démarrage du conteneur. Cela ne crée pas un nouvel environnement virtuel et n’installe pas les dépendances du dépôt pour chaque tâche.

Comment un script Python reçoit-il paramètres et identifiants ?

Associez des Variable Groups au Task Template. Leurs valeurs deviennent des variables d’environnement lisibles par Python via os.environ. Stockez les valeurs sensibles comme secrets plutôt que dans le code. Validez les entrées d’exécution avant de les utiliser dans des requêtes API ou des chemins de fichiers.

Où stocker un rapport CSV ou JSON généré ?

Faites écrire les rapports par votre script dans un stockage durable utilisé par votre processus, comme un stockage objet ou une destination partagée. Affichez une référence utile dans la sortie de tâche. L’historique Semaphore conserve états et journaux plutôt que de servir de dépôt général de fichiers.

Puis-je valider la configuration avec Python avant le déploiement ?

Oui. Utilisez votre script et vos bibliothèques pour valider la configuration et renvoyer un code non nul si une vérification échoue. Placez ce Task Template avant Terraform ou Ansible dans un workflow. Semaphore coordonne les tâches au lieu de fournir un validateur intégré.

Puis-je planifier une synchronisation d’inventaire ou un rapport Python ?

Oui. Créez un Task Template Python avec script, entrées d’environnement et paquets requis, puis ajoutez une planification. Votre code effectue synchronisation API ou génération de rapport. Semaphore enregistre chaque exécution et peut alerter selon les résultats configurés.

Les vérifications Python peuvent-elles suivre Ansible ou Terraform ?

Oui. Ajoutez le Task Template Python après le provisionnement ou la configuration dans un workflow. Vérifiez la disponibilité applicative ou une autre condition examinable par le script. Le code de sortie détermine si le chemin de réussite ou d’échec configuré est suivi.

Mon équipe peut-elle exécuter des travaux Python sans installer Python localement ?

Oui. Python et ses paquets s’exécutent dans l’environnement de Semaphore. Les collègues utilisent le travail enregistré via l’interface ou l’API et examinent sa sortie. Configurez rôles et entrées pour qu’ils exécutent l’opération avec les accès nécessaires.