
Locale
Esegui direttamente sull’host runner usando strumenti e dipendenze installati lì.
Usa runner di progetto per reti separate, capacità e strumenti necessari. Conserva cronologia e risultati in Semaphore.
 Semaphore
I job richiedono reti, strumenti e capacità diverse. Eseguirli tutti sul server applicativo significa condividere gli stessi limiti.
Scegli dove eseguire ogni job, prepara gli strumenti e aggiungi capacità indipendentemente dal server Semaphore.
Crea un runner di progetto, assegnagli un nome e abilitalo. I tag possono essere aggiunti qui o aggiornati in seguito.
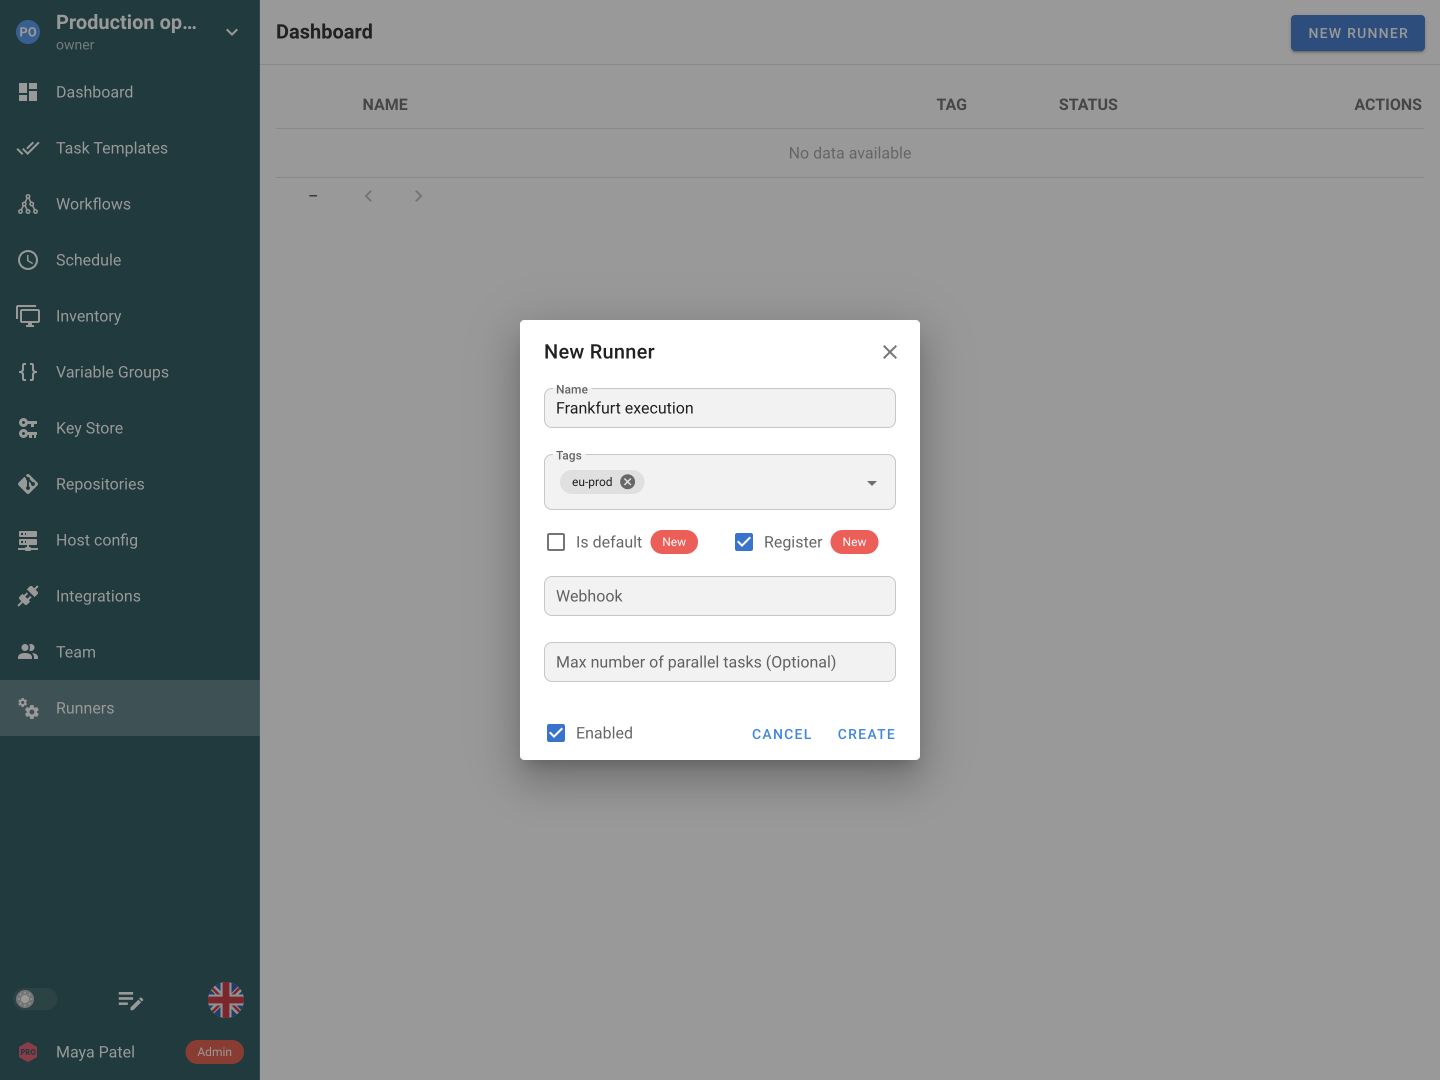
Installa Semaphore sulla macchina di esecuzione e avvialo in modalità runner con la configurazione generata. Verifica che il runner appaia online.
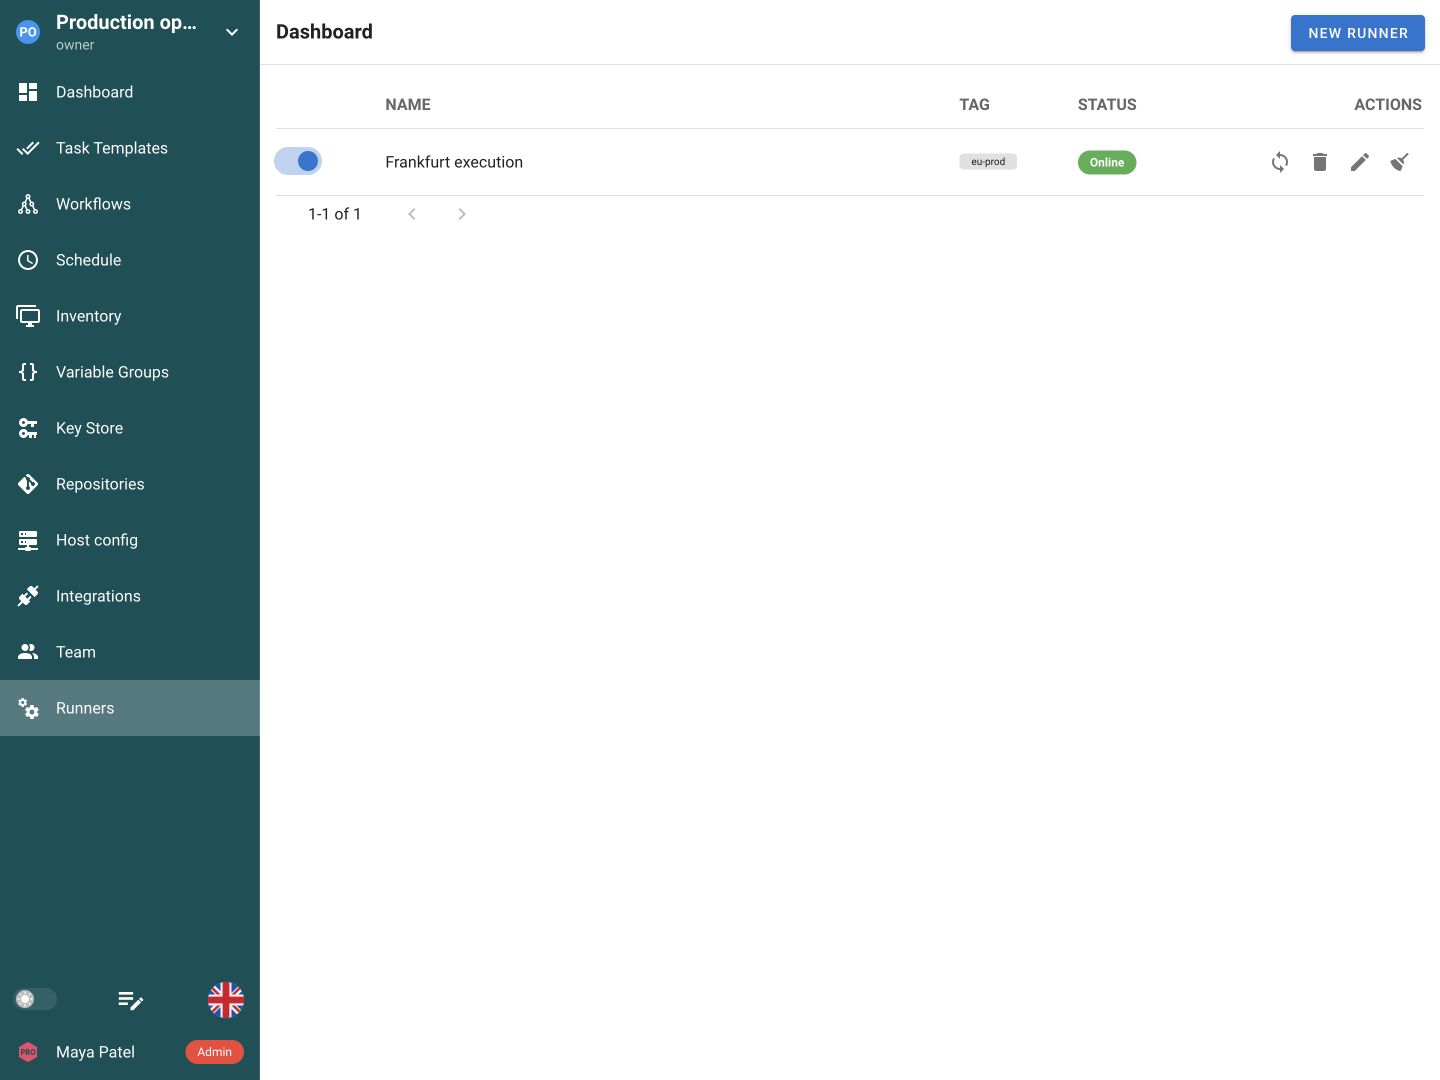
Assegna tag ai runner per posizione, ambiente o carico. Un runner può avere più tag.
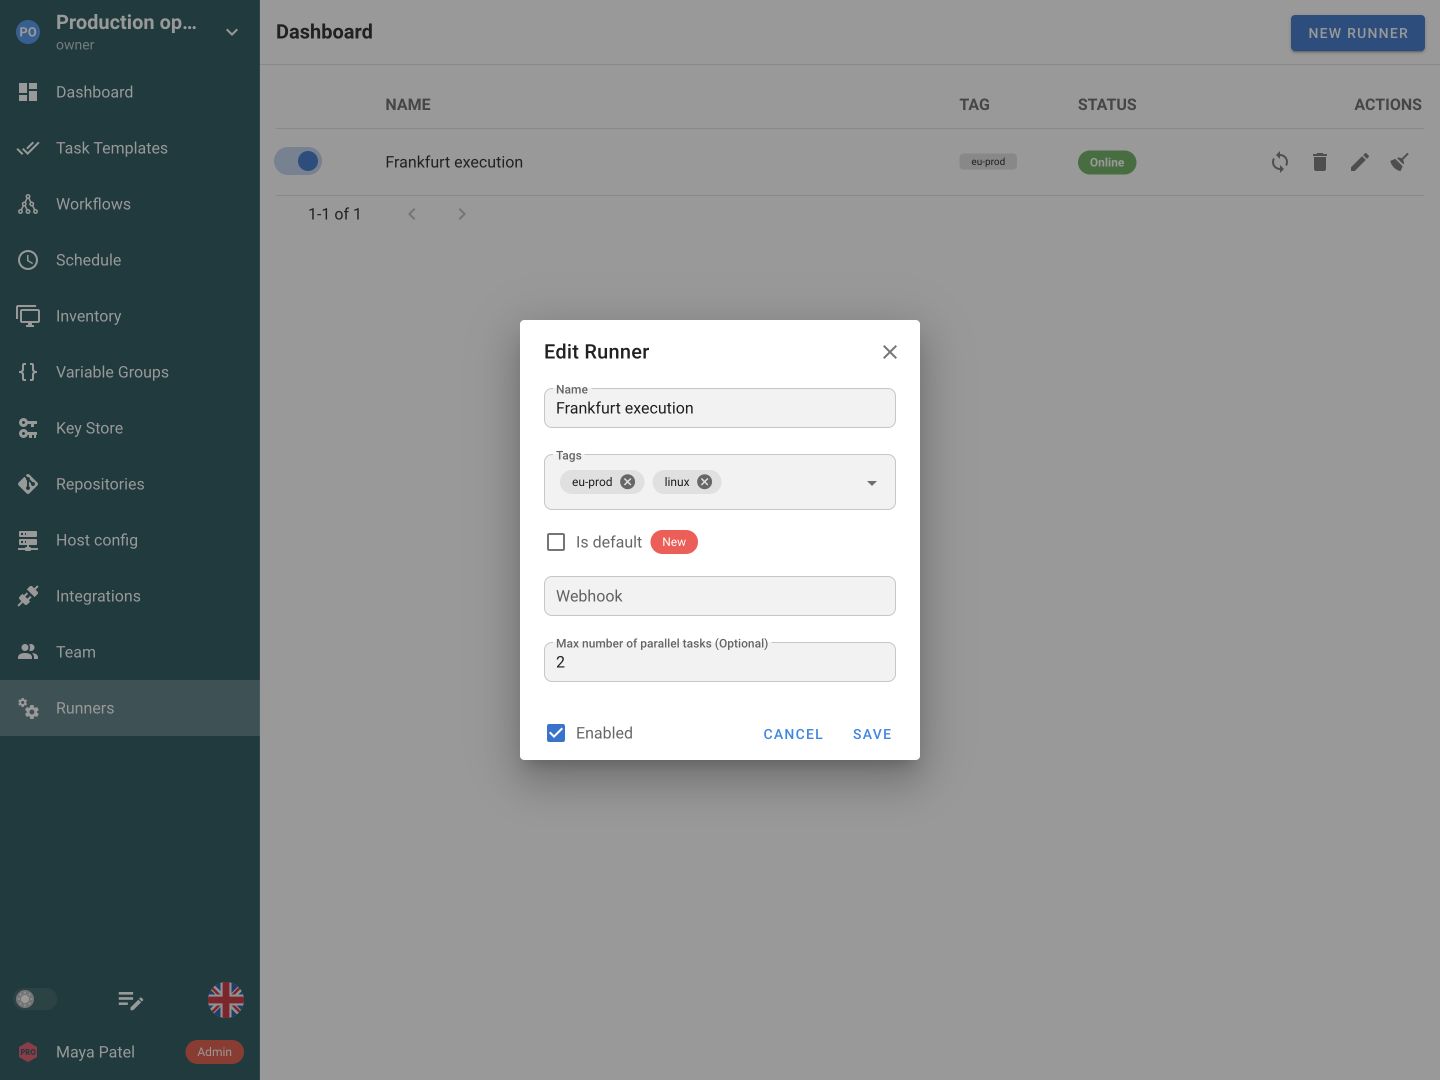
Imposta nel Task Template un tag runner corrispondente. I nuovi task attendono un runner online con quel tag.
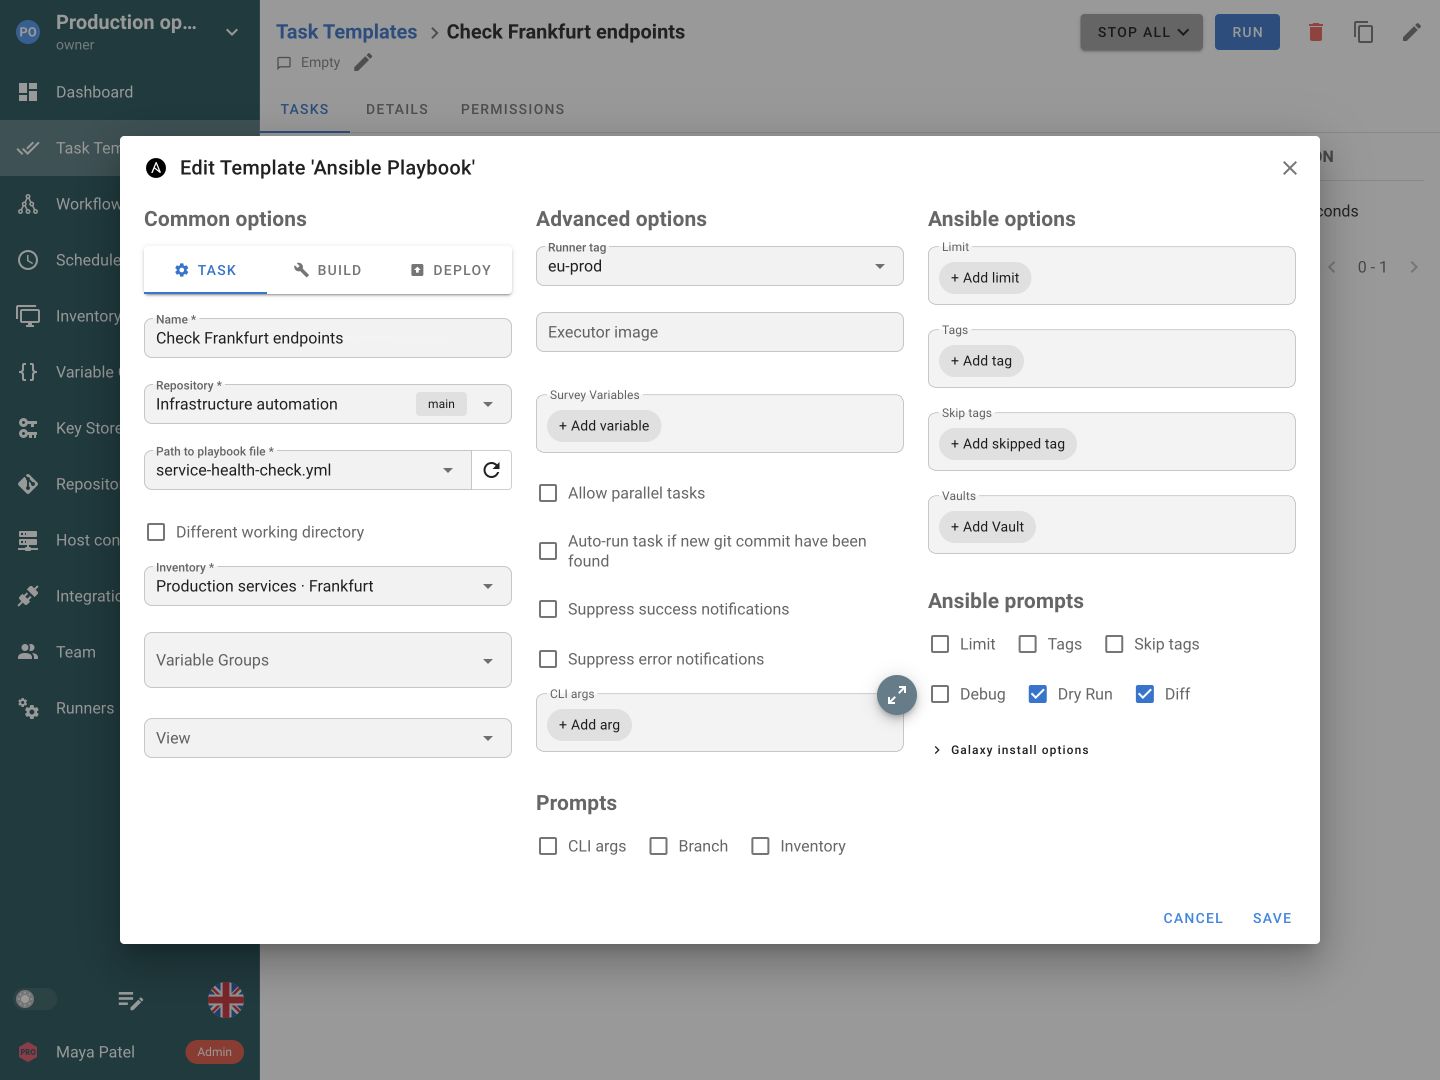
Il runner determina dove viene eseguito il job. Il suo executor determina se usa l’ambiente host o parte in un container.
Esegui direttamente sull’host runner usando strumenti e dipendenze installati lì.
In Pro esegui job in container e scegli un’immagine executor per ogni Task Template.
In Enterprise esegui job in pod Kubernetes con immagine e dipendenze necessarie.

Esegui l’automazione nella regione o rete delle destinazioni. Un runner può raggiungere una sottorete privata, ridurre la distanza dai sistemi gestiti o fornire capacità dedicata a un team. Posizione di rete, tag ed executor risolvono parti diverse della configurazione.
Un runner si connette al server Semaphore e lo interroga. Il server non deve avviare una connessione in ingresso verso il runner. È utile dietro NAT o in una sottorete privata, purché il runner raggiunga Semaphore e le destinazioni e fonti richieste dai suoi task.
I runner globali sono disponibili tra progetti, mentre quelli di progetto appartengono a un solo progetto. I tag supportati collegano requisiti dei modelli a capacità o posizioni dei runner. Le impostazioni predefinite coprono task senza requisiti di tag. Senza un runner adatto il task può attendere anziché essere eseguito silenziosamente altrove.
L’esecuzione locale usa il contesto del processo dell’host runner e i suoi permessi. Gli executor Docker e Kubernetes supportati introducono un confine di container o pod con requisiti di configurazione ed edizione propri. Mount, rete, privilegi e immagini definiscono il confine effettivo: la sola parola runner non garantisce isolamento.
Runner aggiuntivi possono aumentare capacità o copertura senza eseguire ogni task sull’host web. Impostazioni di parallelismo e polling influiscono sul funzionamento. Schemi avanzati monouso possono combinare registrazione, hook di assegnazione e un runner che termina dopo un job, ma richiedono automazione del deployment attorno al ciclo di vita.
Usa una licenza offline Enterprise per reti chiuse. Mantieni Semaphore e runner all’interno e fornisci repository, immagini executor e dipendenze senza rete pubblica.
L’esecuzione locale usa i permessi dell’host runner. Usa executor Docker o Kubernetes se i job richiedono container o pod propri, con immagini, mount e rete adeguati.
I task richiedono credenziali e configurazione del modello. Le fonti d’ambiente e file del Key Store sono risolte sul server prima dell’uso in esecuzione.
I runner globali sono registrati per l’intera istanza; quelli di progetto appartengono a un progetto specifico. L’esecuzione distribuita globale è disponibile in tutte le offerte; ambito di progetto e instradamento correlato sono inclusi in Pro ed Enterprise secondo i prezzi. Scegli in base a responsabilità operativa e accesso agli ambienti. Un runner dedicato rende deliberata la posizione, ma la configurazione determina ancora cosa può raggiungere il processo.
Il runner avvia la comunicazione connettendosi e interrogando Semaphore. Può quindi stare dietro NAT o in rete privata senza connessioni in ingresso avviate dal server. Deve ancora raggiungere Semaphore, repository, fonti dei pacchetti, servizi esterni e destinazioni. Verifica ogni percorso: il polling in uscita non elimina gli altri requisiti di rete.
Usa tag supportati, requisiti del modello e impostazioni predefinite per scegliere l’ambiente. Dai ai tag significati di capacità o posizione e rendi visibili disponibilità e capacità. Senza runner pronto il task può attendere. Testa con un’operazione innocua e conferma il runner nei dettagli prima della produzione.
Non da solo. Un executor locale usa il contesto del processo dell’host runner con i relativi accessi. Docker o Kubernetes introducono un confine diverso, ma mount, privilegi, rete e contenuti delle immagini restano importanti. Scegli separatamente posizione e modalità. Prepara le dipendenze e verifica l’host, senza considerare runner o container una garanzia completa di sicurezza.
Prepara l’ambiente richiesto da ogni job nel percorso scelto. Le impostazioni supportate delle immagini executor aiutano a fissare dipendenze Ansible, Terraform, Python o altre senza cambiare ogni job su un host condiviso. Verifica versione ed edizione per le opzioni pertinenti. Poi testa repository, pacchetti e connettività dentro quell’ambiente reale, non solo da una sessione amministrativa.
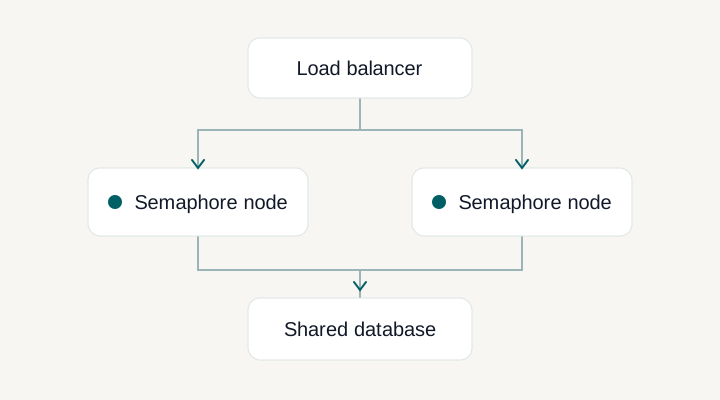
Aggiungere runner espande o sposta l’esecuzione dei task; non crea un piano di controllo applicativo ad alta disponibilità. La HA applicativa usa più nodi Semaphore coordinati con l’architettura documentata di database condiviso, Redis e bilanciamento. Queste funzionalità si completano ma risolvono problemi diversi. Determina se il limite è capacità, raggiungibilità di rete o accesso a interfaccia e API prima di scegliere quale parte scalare.
Il task attende finché un runner disponibile soddisfa i requisiti del modello. Verifica tag, abilitazione e ultima connessione, poi capacità. Un tag è una regola di selezione: runner senza tag o con tag diversi non prendono automaticamente il job.
Sì. Il modello sostituisce l’immagine predefinita con executor Docker in Pro o Kubernetes in Enterprise. I job usano così la toolchain necessaria. Prepara l’immagine con applicazioni e dipendenze; il campo non modifica l’executor locale. Vedi le impostazioni di esecuzione.