
Local
Exécutez directement sur l’hôte du runner avec les outils et dépendances installés sur celui-ci.
Utilisez les runners de projet pour joindre des réseaux distincts, ajouter de la capacité et fournir les outils nécessaires aux travaux. Gardez historique et résultats dans Semaphore.
 Semaphore
Les travaux nécessitent différents accès réseau, outils et capacités. Les exécuter tous sur le serveur applicatif leur impose les mêmes limites.
Choisissez où s’exécute chaque travail, préparez ses outils et ajoutez de la capacité indépendamment du serveur Semaphore.
Créez un runner de projet, nommez-le et activez-le. Les tags peuvent être ajoutés ici ou modifiés plus tard.
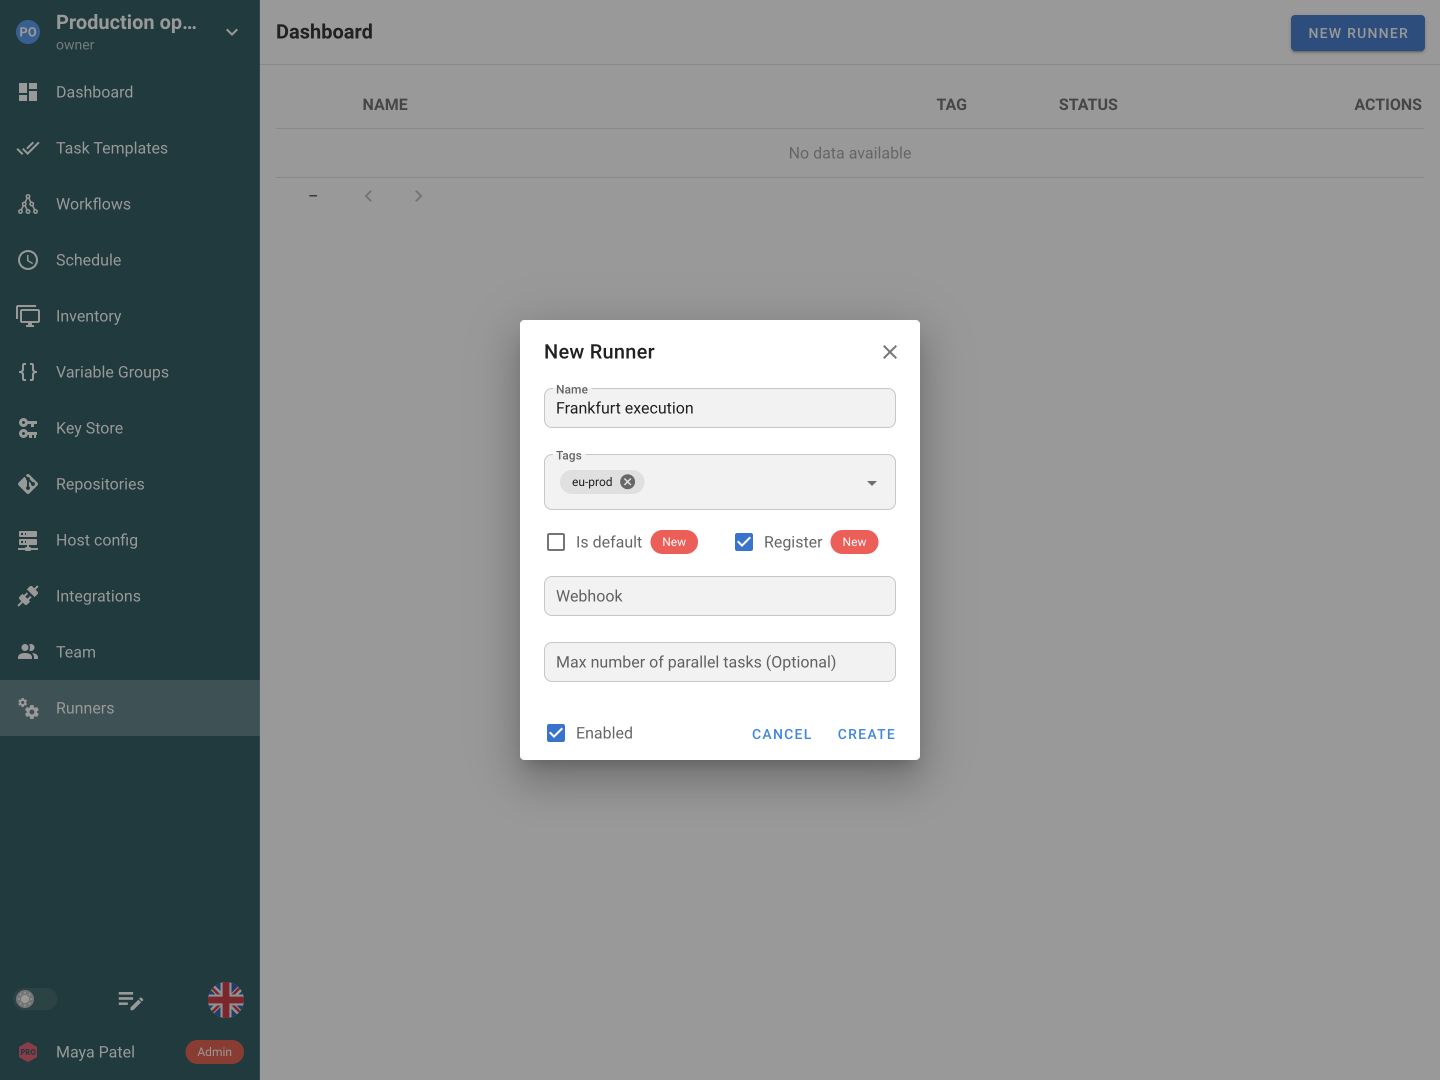
Installez Semaphore sur la machine d’exécution et démarrez-le en mode runner avec sa configuration générée. Vérifiez que le runner apparaît en ligne.
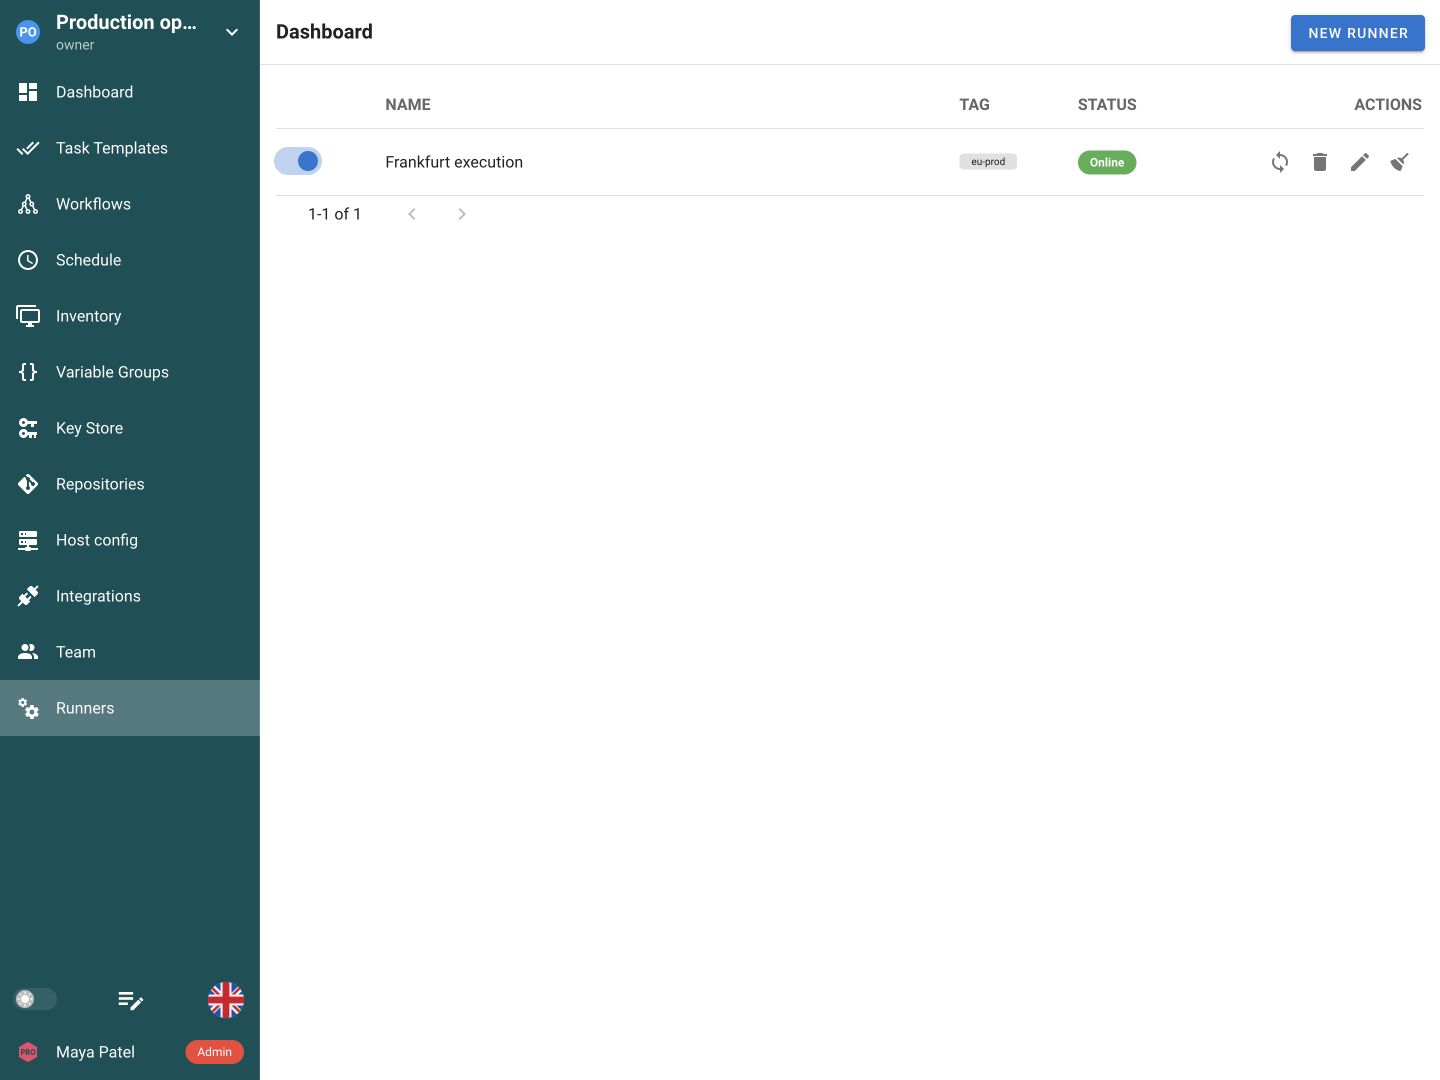
Attribuez des tags aux runners selon emplacement, environnement ou charge. Un runner peut porter plusieurs tags.
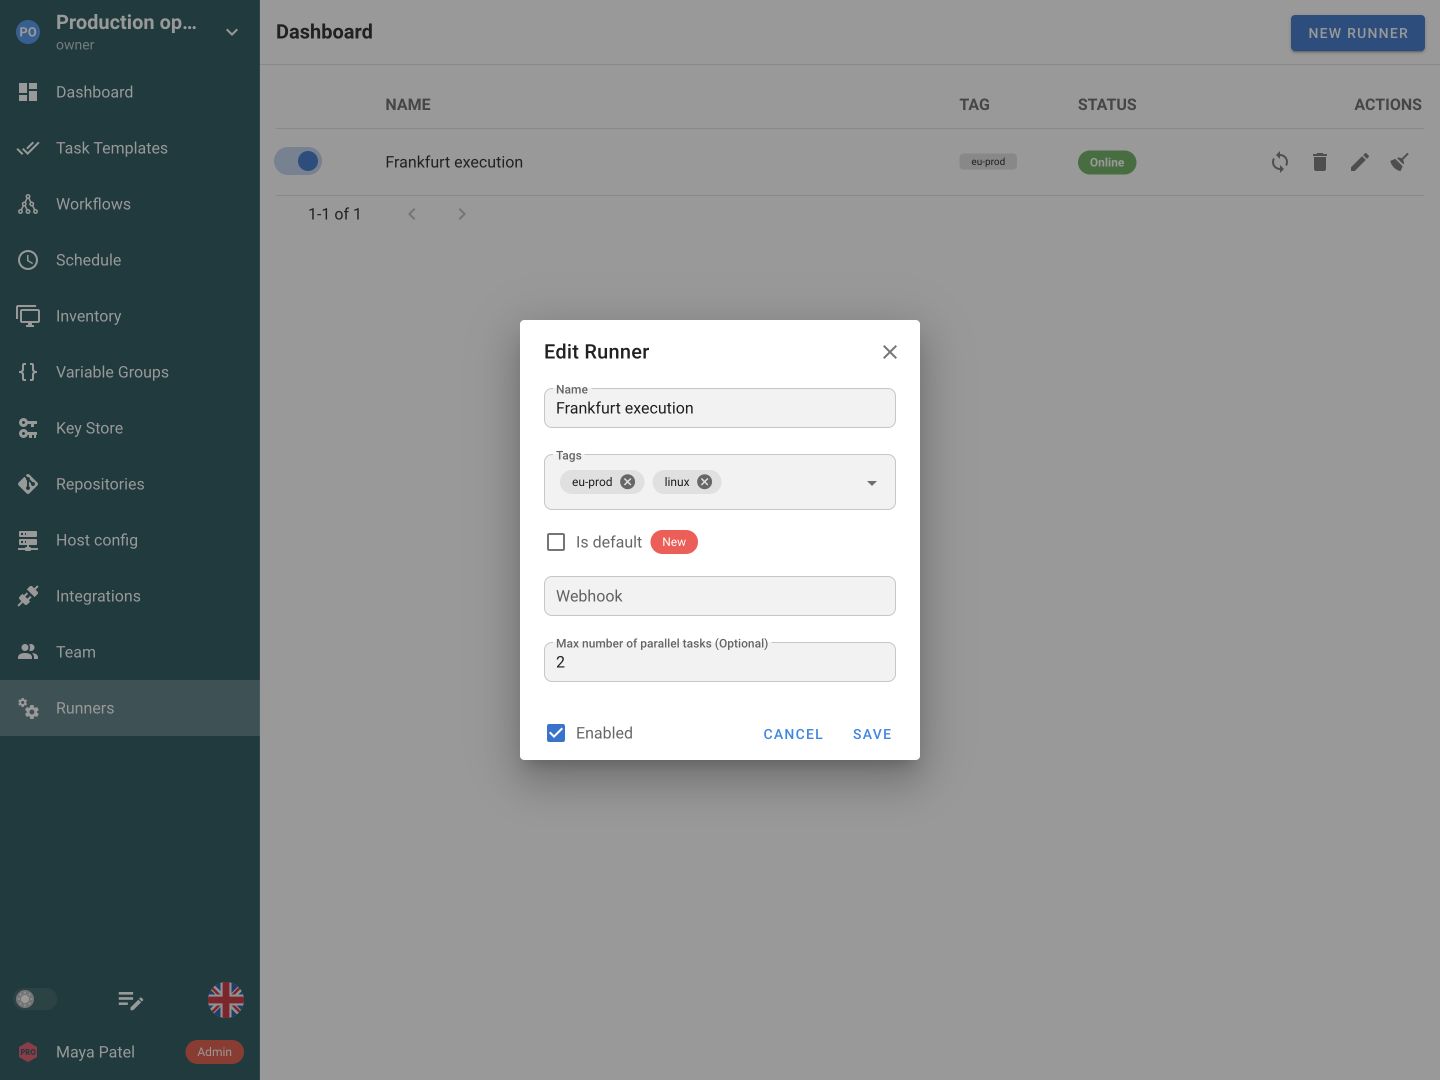
Définissez le tag de runner du Task Template sur une valeur correspondante. Les nouvelles tâches attendent un runner en ligne portant ce tag.
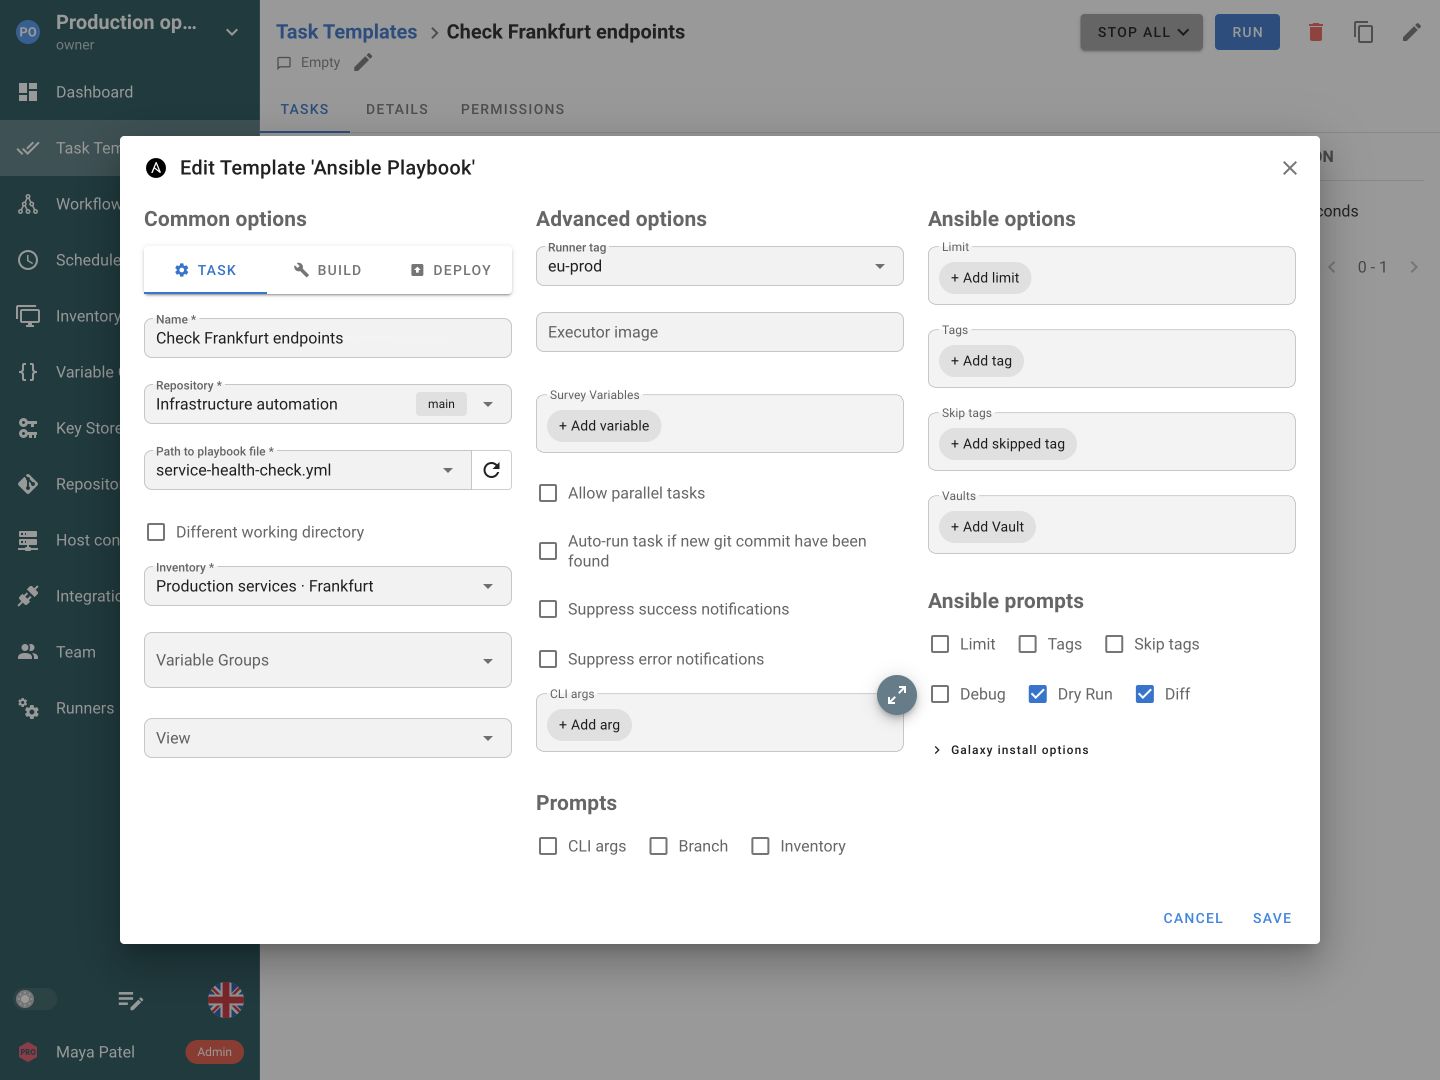
Le runner détermine où le travail s’exécute. Son exécuteur détermine si le travail utilise l’environnement de l’hôte ou démarre dans un conteneur.
Exécutez directement sur l’hôte du runner avec les outils et dépendances installés sur celui-ci.
Dans Pro, exécutez les travaux dans des conteneurs et choisissez une image d’exécuteur par Task Template.
Dans Enterprise, exécutez les travaux dans des pods Kubernetes avec l’image et les dépendances nécessaires.

Exécutez l’automatisation dans la région ou le réseau de ses cibles. Un runner peut accéder à un sous-réseau privé, réduire la distance aux systèmes gérés ou donner à une équipe une capacité dédiée. Placement réseau, tags de runner et exécuteur répondent chacun à une partie différente de cette configuration.
Un runner se connecte au serveur Semaphore et l’interroge. Le serveur n’a pas besoin d’établir une connexion entrante vers ce runner. C’est utile pour un site derrière un NAT ou dans un sous-réseau privé, à condition que le runner puisse joindre Semaphore ainsi que les cibles et sources nécessaires à ses tâches.
Les runners globaux sont disponibles dans plusieurs projets, tandis que les runners de projet appartiennent à un seul projet. Les tags pris en charge relient les exigences des modèles aux capacités ou emplacements des runners. Les réglages de runner par défaut couvrent les tâches sans exigence de tag. Sans runner approprié, une tâche peut rester en attente plutôt que s’exécuter silencieusement ailleurs.
L’exécution locale utilise le contexte de processus de l’hôte du runner et ses autorisations. Les exécuteurs Docker et Kubernetes pris en charge introduisent une limite de conteneur ou de pod, avec leurs propres exigences de configuration et d’édition. Montages, réseau, privilèges et images déterminent la limite réelle ; le mot runner seul ne garantit aucune isolation.
Des runners supplémentaires peuvent ajouter de la capacité ou de la portée sans exécuter chaque tâche sur l’hôte de l’application web. Les réglages de parallélisme et d’interrogation influencent le fonctionnement. Des schémas avancés à usage unique peuvent combiner l’enregistrement, des hooks d’affectation et un runner qui s’arrête après un travail, mais ils nécessitent une automatisation du déploiement autour de ce cycle de vie.
Utilisez une licence hors ligne Enterprise si l’installation doit fonctionner dans un réseau fermé. Gardez Semaphore et ses runners dans cet environnement et fournissez dépôts Git, images d’exécuteur et dépendances sans accès réseau public.
L’exécution locale utilise les autorisations de processus de l’hôte du runner. Utilisez des exécuteurs Docker ou Kubernetes lorsque les travaux nécessitent leur propre conteneur ou pod, avec images, montages et paramètres réseau adaptés.
Les tâches ont besoin des identifiants et configurations référencés par leur modèle. Les sources d’environnement et de fichiers du Key Store sont résolues sur le serveur Semaphore avant l’utilisation de la valeur pour l’exécution.
Les runners globaux sont enregistrés pour toute l’instance, tandis que les runners de projet appartiennent à un projet particulier. L’exécution distribuée globale est disponible dans toutes les offres ; le périmètre projet et les fonctions de routage associées sont inclus dans Pro et Enterprise selon la tarification. Choisissez le périmètre selon la responsabilité opérationnelle et l’accès aux environnements. Un runner propre au projet permet un placement délibéré, mais sa configuration d’exécution détermine encore les accès du processus exécuté.
Le runner établit la communication en se connectant à Semaphore et en l’interrogeant pour obtenir du travail. Cela permet un placement derrière NAT ou dans un réseau privé sans connexion entrante initiée par le serveur. Il doit toujours joindre Semaphore ainsi que dépôts, sources de paquets, services externes et cibles utilisés par ses tâches. Vérifiez chaque chemin : l’interrogation sortante ne supprime pas les autres exigences réseau.
Utilisez tags de runners, exigences de modèle et réglages par défaut pris en charge pour associer le travail à un environnement approprié. Nommez les tags selon une capacité ou un emplacement significatif et gardez disponibilité et capacité visibles. Sans runner adapté prêt, la tâche peut attendre. Testez le parcours choisi avec une opération sans danger et confirmez le runner dans les détails avant de l’utiliser en production.
Pas à lui seul. Un exécuteur local utilise le contexte de processus de l’hôte du runner avec les accès fournis par cet environnement. Docker ou Kubernetes introduisent une autre limite, mais montages, privilèges, réseau et contenu des images restent déterminants. Choisissez séparément placement et mode d’exécution. Préparez les dépendances et vérifiez l’accès à l’hôte plutôt que de considérer runner ou conteneur comme une garantie de sécurité complète.
Préparez l’environnement requis par chaque travail sur son parcours d’exécution choisi. Les réglages d’image d’exécuteur pris en charge aident à fixer un ensemble de dépendances Ansible, Terraform, Python ou autres sans modifier tous les travaux d’un hôte partagé. Vérifiez version et édition installées pour les options concernées. Testez ensuite accès au dépôt, paquets et connexions cibles dans cet environnement réel, pas uniquement depuis une session administrateur interactive.
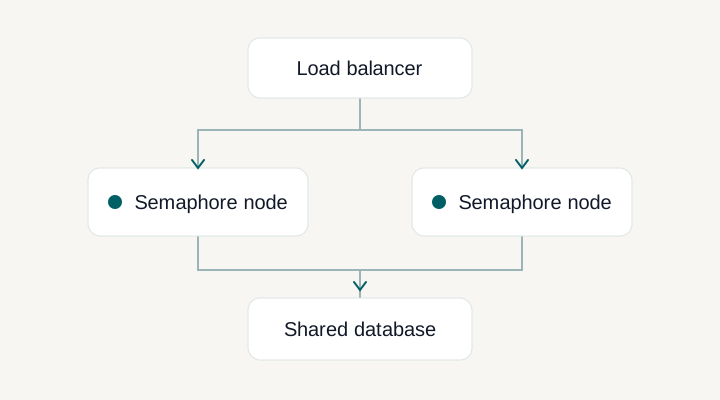
Ajouter des runners étend ou déplace l’exécution des tâches ; cela ne crée pas un plan de contrôle applicatif hautement disponible. La haute disponibilité applicative utilise plusieurs nœuds Semaphore coordonnés avec l’architecture documentée de base partagée, Redis et répartition de charge. Ces fonctions se complètent, mais répondent à des problèmes différents. Déterminez si votre limite concerne la capacité d’exécution, l’accès réseau ou l’accès à l’interface et à l’API avant de choisir la partie à dimensionner.
La tâche reste en attente jusqu’à ce qu’un runner disponible corresponde aux exigences de routage du modèle. Vérifiez tag, activation et dernier état de connexion du runner, puis sa capacité. Un tag est une règle de sélection : un runner sans tag ou avec un autre tag ne récupère pas automatiquement ce travail.
Oui. Un modèle peut remplacer l’image de travail par défaut si le runner utilise Docker dans Pro ou Kubernetes dans Enterprise. Chaque travail dispose ainsi de sa chaîne d’outils. Préparez l’image avec applications et dépendances ; le champ ne change pas l’exécution locale. Voir les réglages d’exécution du modèle.