
Lokal
Direkt auf dem Runner-Host ausführen und die dort installierten Tools und Abhängigkeiten verwenden.
Nutzen Sie Projekt-Runner, um getrennte Netzwerke zu erreichen, Ausführungskapazität zu ergänzen und Jobs die benötigten Tools zu geben. Bewahren Sie Task-Historie und Ergebnisse in Semaphore auf.
 Semaphore
Jobs benötigen unterschiedlichen Netzwerkzugriff, unterschiedliche Tools und Kapazitäten. Werden alle auf dem Anwendungsserver ausgeführt, teilen sie dieselben Grenzen.
Wählen Sie den Ausführungsort jedes Jobs, stellen Sie seine Tools bereit und erweitern Sie die Kapazität unabhängig vom Semaphore-Server.
Erstellen Sie einen Project Runner, benennen und aktivieren Sie ihn. Tags können Sie hier hinzufügen oder später aktualisieren.
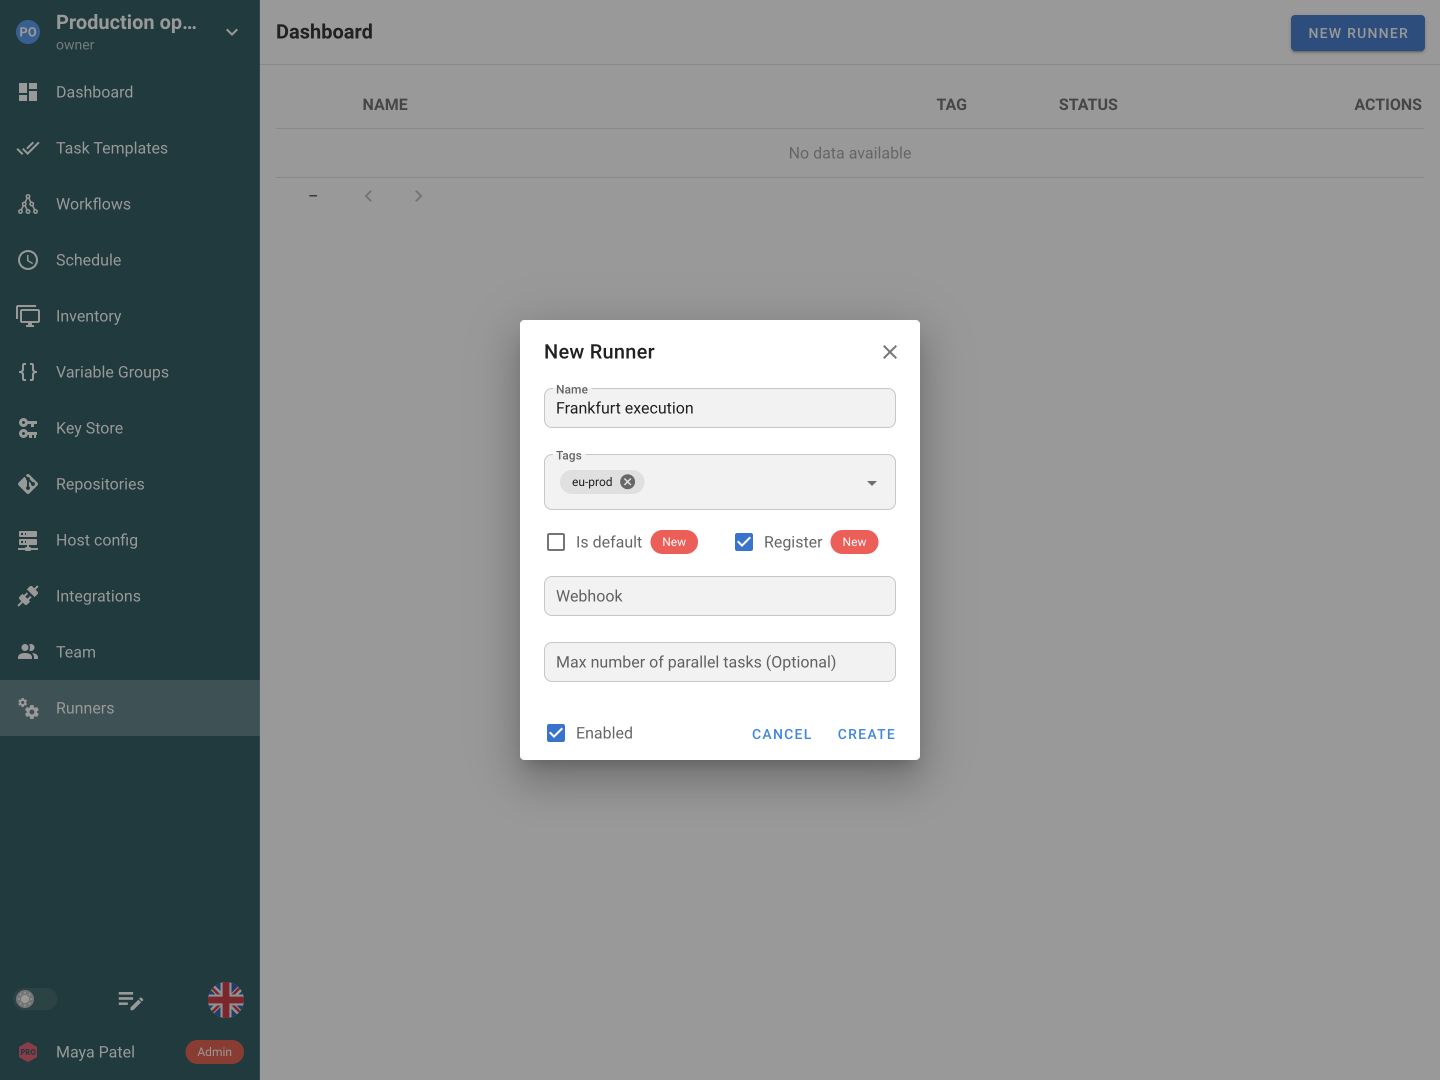
Installieren Sie Semaphore auf dem Ausführungsrechner und starten Sie es mit der erzeugten Konfiguration im Runner-Modus. Prüfen Sie, ob der Runner als Online angezeigt wird.
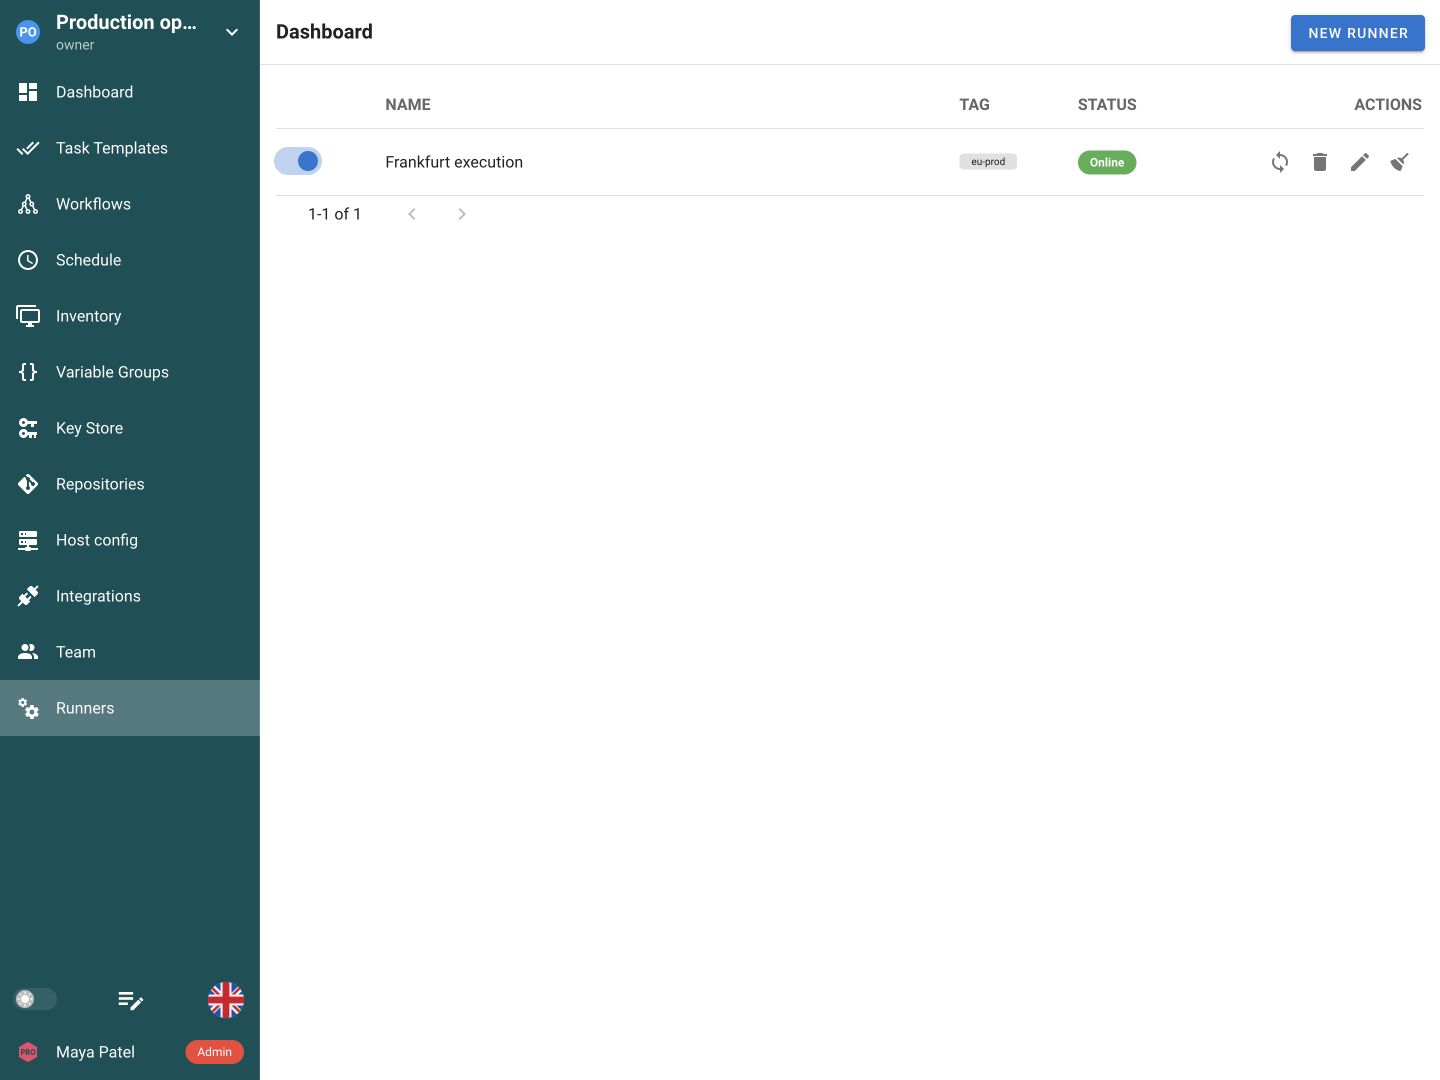
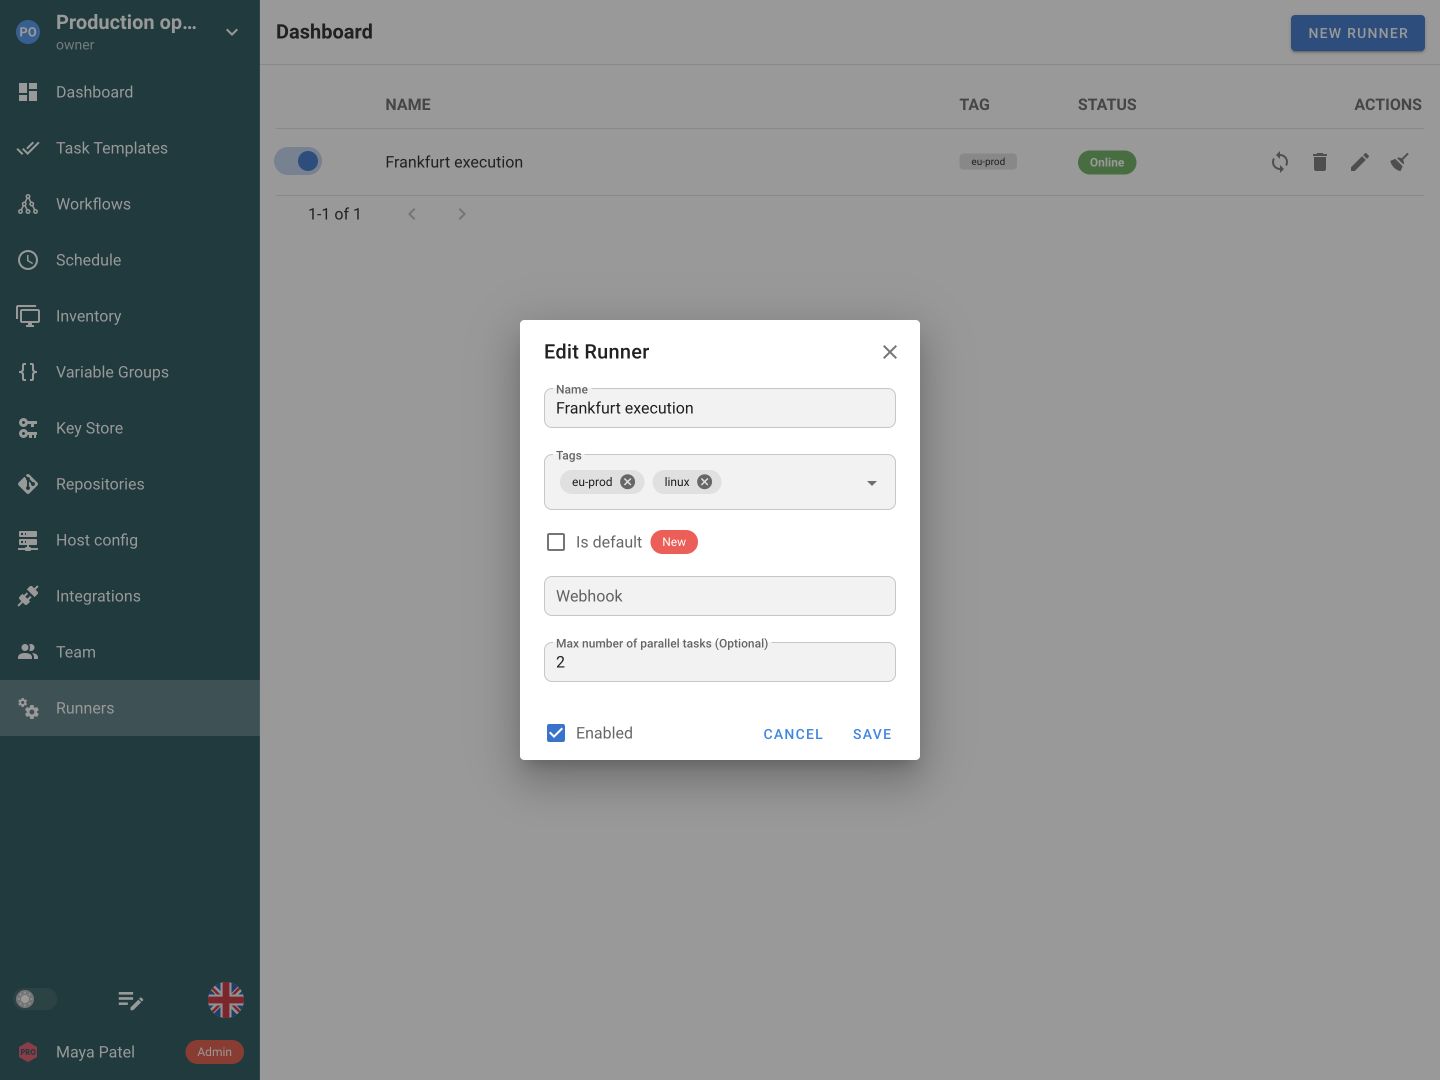
Versehen Sie Runner mit Tags für Standort, Umgebung oder Arbeitslast. Ein Runner kann mehrere Tags besitzen.
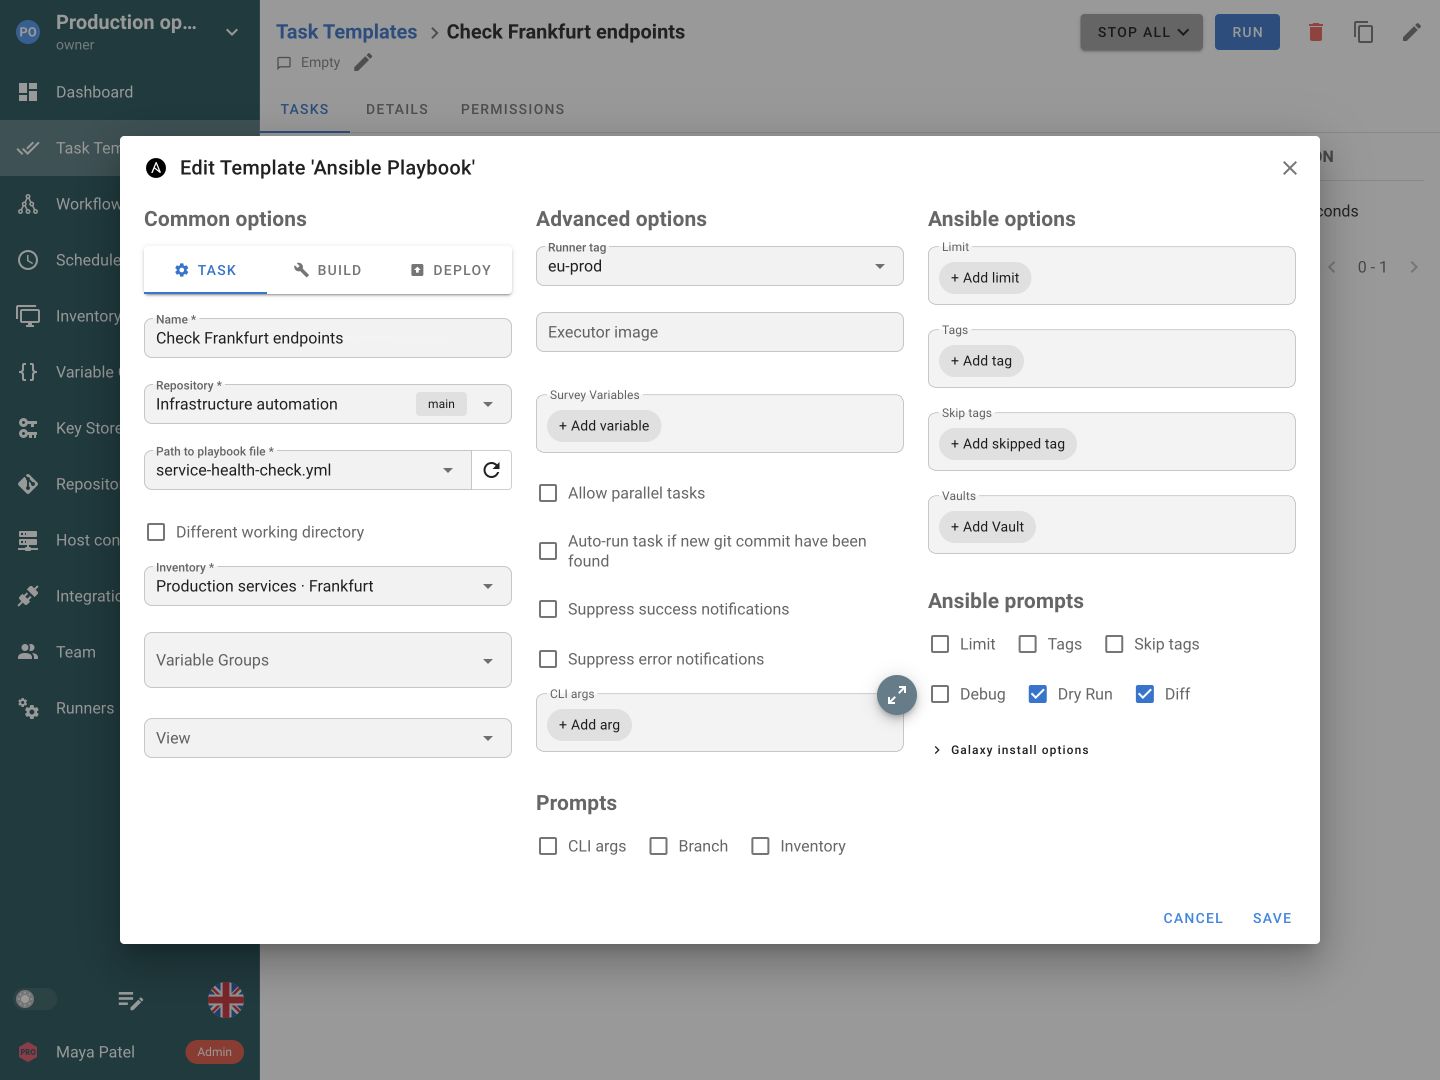
Setzen Sie den Runner-Tag im Task Template auf einen passenden Wert. Neue Tasks warten auf einen Online-Runner mit diesem Tag.
Ein Runner bestimmt, wo der Job ausgeführt wird. Sein Executor bestimmt, ob er die Hostumgebung verwendet oder in einem Container startet.
Direkt auf dem Runner-Host ausführen und die dort installierten Tools und Abhängigkeiten verwenden.
Führen Sie in Pro Jobs in Containern aus und wählen Sie für jedes Task Template ein Executor-Image.
Führen Sie in Enterprise Jobs in Kubernetes-Pods mit dem benötigten Image und den erforderlichen Abhängigkeiten aus.

Führen Sie Automatisierung in der Region oder dem Netzwerk ihrer Ziele aus. Ein Runner kann Zugriff auf ein privates Subnetz bieten, die Entfernung zu verwalteten Systemen verringern oder einem Team eigene Ausführungskapazität geben. Netzwerkplatzierung, Runner-Tags und Executor lösen jeweils einen anderen Teil dieser Einrichtung.
Ein Runner verbindet sich mit dem Semaphore-Server und fragt dort Aufgaben ab. Der Server muss keine eingehende Verbindung zum Runner aufbauen. Das ist für Standorte hinter NAT oder in privaten Subnetzen hilfreich, sofern der Runner Semaphore sowie die benötigten Zielsysteme und Quellen erreichen kann.
Globale Runner stehen projektübergreifend zur Verfügung, während Projekt-Runner einem Projekt gehören. Unterstützte Tags verbinden Vorlagenanforderungen mit Fähigkeiten oder Standorten von Runnern. Einstellungen für Standard-Runner gelten für Tasks ohne Tag-Anforderung. Wenn kein geeigneter Runner verfügbar ist, kann ein Task warten, statt unbemerkt an einem anderen Ort ausgeführt zu werden.
Bei lokaler Ausführung läuft der Prozess im Kontext des Runner-Hosts und nutzt dessen Berechtigungen. Unterstützte Docker- und Kubernetes-Executors schaffen eine Container- oder Pod-Grenze mit eigenen Konfigurations- und Editionsanforderungen. Ihre Mounts, Netzwerke, Berechtigungen und Images bestimmen die tatsächliche Grenze; das Wort Runner allein garantiert keine Isolation.
Zusätzliche Runner schaffen Kapazität oder Erreichbarkeit, ohne jede Aufgabe auf dem Host der Webanwendung auszuführen. Einstellungen für parallele Aufgaben und Polling beeinflussen das Betriebsverhalten. Fortgeschrittene Muster für einzelne Jobs können Registrierung, Zuweisungs-Hooks und einen Runner kombinieren, der nach dem Job beendet wird. Dafür ist eine zusätzliche Automatisierung dieses Lebenszyklus nötig.
Nutzen Sie eine Enterprise-Offline-Lizenz, wenn die Installation in einem geschlossenen Netzwerk arbeiten muss. Halten Sie Semaphore und seine Runner in dieser Umgebung und stellen Sie die benötigten Git-Repositories, Executor-Images und Tool-Abhängigkeiten ohne öffentlichen Netzwerkzugriff bereit.
Die lokale Ausführung nutzt die Prozessberechtigungen des Runner-Hosts. Verwenden Sie Docker- oder Kubernetes-Executors, wenn Jobs einen eigenen Container oder Pod benötigen, mit für den Task geeigneten Images, Mounts und Netzwerkeinstellungen.
Tasks benötigen die von ihrer Vorlage referenzierten Zugangsdaten und Konfigurationen. Umgebungs- und Dateiquellen im Key Store werden auf dem Semaphore-Server aufgelöst, bevor der Wert zur Ausführung verwendet wird.
Globale Runner werden für die gesamte Instanz registriert, während Projekt-Runner einem bestimmten Projekt gehören. Globale verteilte Ausführung ist in allen Tarifen verfügbar; Projektumfang und zugehörige Routing-Funktionen sind gemäß Preisseite in Pro und Enterprise enthalten. Wählen Sie den Umfang nach Betriebsverantwortung und Umgebungszugriff. Ein projektspezifischer Runner ermöglicht eine bewusste Platzierung; was ein ausgeführter Prozess erreichen kann, bestimmt weiterhin seine Laufzeitkonfiguration.
Der Runner baut die Verbindung auf, indem er sich mit Semaphore verbindet und nach Arbeit fragt. Das ermöglicht eine Platzierung hinter NAT oder in einem privaten Netzwerk ohne vom Server initiierte eingehende Verbindung zum Runner. Der Runner muss weiterhin den Semaphore-Endpunkt und die von seinen Tasks verwendeten Repositories, Paketquellen, externen Dienste und Ziele erreichen. Prüfen Sie diese Verbindungen einzeln; ausgehende Abfragen beseitigen nicht alle anderen Netzwerkanforderungen.
Nutzen Sie unterstützte Runner-Tags, Vorlagenanforderungen und Standard-Runner-Einstellungen, um Arbeit einer passenden Ausführungsumgebung zuzuordnen. Benennen Sie Tags nach einer aussagekräftigen Fähigkeit oder einem Standort und halten Sie Verfügbarkeit und Kapazität sichtbar. Ist kein geeigneter Runner bereit, kann ein Task warten. Testen Sie die gewählte Route mit einem ungefährlichen Vorgang und bestätigen Sie den ausführenden Runner in den Task-Details, bevor Sie denselben Weg für Produktionsänderungen nutzen.
Nicht von selbst. Ein lokaler Executor läuft im Prozesskontext des Runner-Hosts mit dem dort verfügbaren Zugriff. Eine Docker- oder Kubernetes-Ausführung führt eine andere Grenze ein; Mounts, Berechtigungen, Netzwerk und Image-Inhalte bleiben jedoch entscheidend. Wählen Sie Platzierung und Ausführungsmodus getrennt. Richten Sie die benötigten Abhängigkeiten ein und prüfen Sie den Host-Zugriff, statt Runner oder Container als vollständige Sicherheitsgarantie anzusehen.
Richten Sie die für jeden Job erforderliche Laufzeitumgebung auf seinem gewählten Ausführungsweg ein. Unterstützte Executor-Image-Einstellungen helfen, einen bestimmten Satz von Ansible-, Terraform-, Python- oder anderen Abhängigkeiten festzulegen, ohne jeden Job auf einem gemeinsamen Host zu ändern. Prüfen Sie installierte Version und Edition auf die jeweiligen Executor-Optionen. Testen Sie anschließend Repository-Zugriff, Pakete und Zielverbindungen in genau dieser Umgebung, nicht nur in einer interaktiven Administratorsitzung.
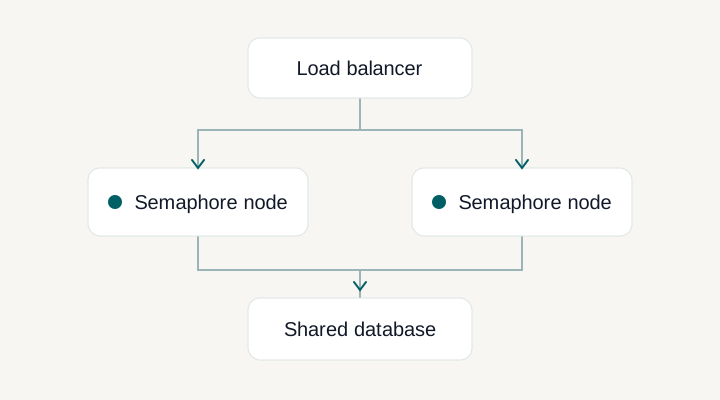
Zusätzliche Runner erweitern oder verlagern die Aufgabenausführung. Sie schaffen keine hochverfügbare Anwendungssteuerung. Anwendungs-HA verwendet mehrere koordinierte Semaphore-Knoten mit der dokumentierten Architektur aus gemeinsamer Datenbank, Redis und Lastverteilung. Beide Funktionen können sich ergänzen, lösen aber unterschiedliche Probleme. Klären Sie vor der Skalierung, ob der Engpass bei Ausführungskapazität, Netzwerkerreichbarkeit oder Zugriff auf UI und API liegt.
Der Task wartet, bis ein verfügbarer Runner den Routing-Anforderungen der Vorlage entspricht. Prüfen Sie Runner-Tag, Aktivierung und letzten Verbindungsstatus, danach die Ausführungskapazität. Ein Tag ist eine Auswahlregel. Ein Runner ohne Tag oder mit einem anderen Tag übernimmt diesen Job nicht automatisch.
Ja. Eine Vorlage kann das Standard-Job-Image überschreiben, wenn ihr Runner den Docker-Executor in Pro oder Kubernetes-Executor in Enterprise nutzt. So verwenden Jobs die benötigte Toolchain. Bereiten Sie das Image mit Anwendungen und Abhängigkeiten vor; das Feld ändert das Verhalten lokaler Executors nicht. Vorlagen-Ausführungseinstellungen ansehen.