

HashiCorp Vault
Résolvez les identifiants depuis vos secrets Vault KV existants.
Stockez clés, mots de passe et jetons dans le Key Store intégré ou connectez votre coffre-fort. Réutilisez les identifiants nommés entre travaux, gardez les secrets hors du code et mettez-les à jour à la source.


Stockez les identifiants séparément du code. Réutilisez les clés nommées dans dépôts, inventaires et travaux avec une source de secrets adaptée à votre infrastructure.
Conservez clés SSH, paires identifiant/mot de passe et secrets textuels dans le Key Store chiffré de Semaphore. Réutilisez-les pour l’accès Git, les connexions aux hôtes et les mots de passe Ansible Vault.
Résolvez les identifiants depuis vos secrets Vault KV existants.
Utilisez OpenBao comme source d’identifiants réutilisables.
Connectez les identifiants gérés dans AWS Secrets Manager.
Importez les secrets du coffre-fort dans le Key Store par synchronisation.
Utilisez les identifiants gérés dans Devolutions Server.
Connectez les secrets gérés par CyberArk à l’automatisation.
Besoin d’une autre source ? Résolvez les identifiants depuis les variables d’environnement ou fichiers du serveur, synchronisez les secrets d’un coffre-fort vers le Key Store ou utilisez des valeurs secrètes avec la configuration partagée des Variable Groups.
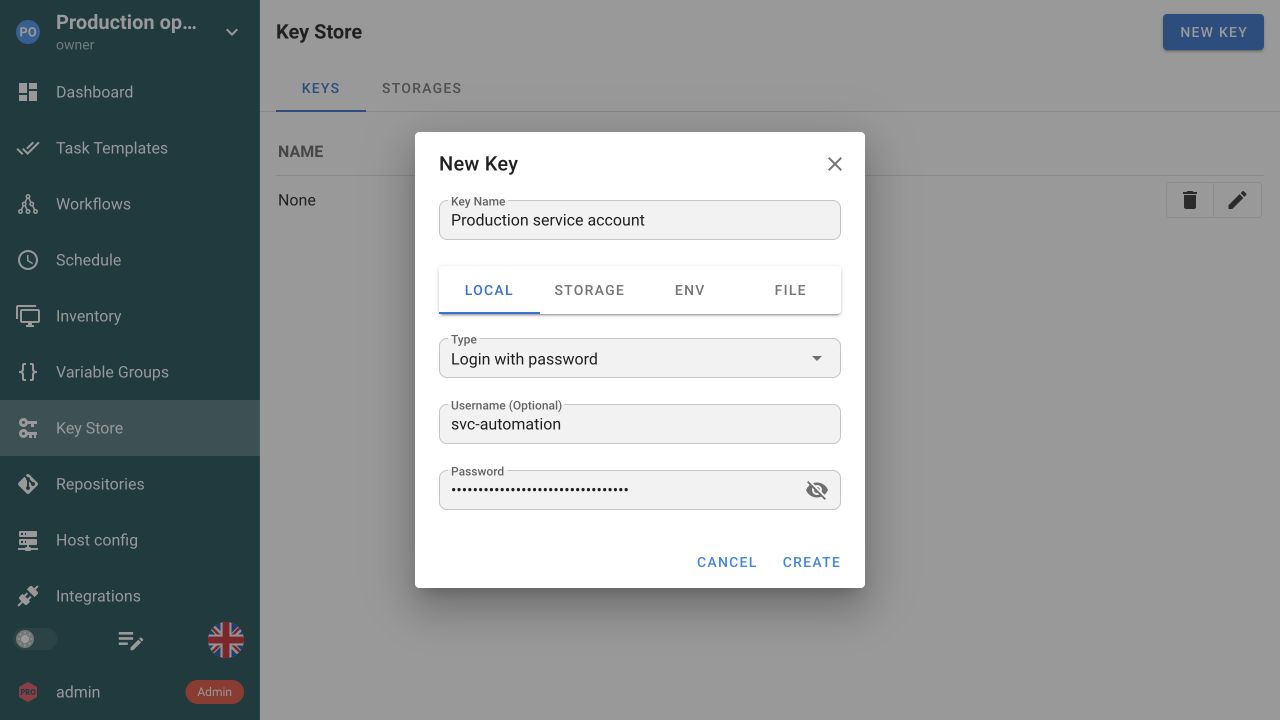
Enregistrez une clé ou une paire identifiant/mot de passe nommée dans le Key Store intégré. Réutilisez-la sans ajouter sa valeur au code d’automatisation.
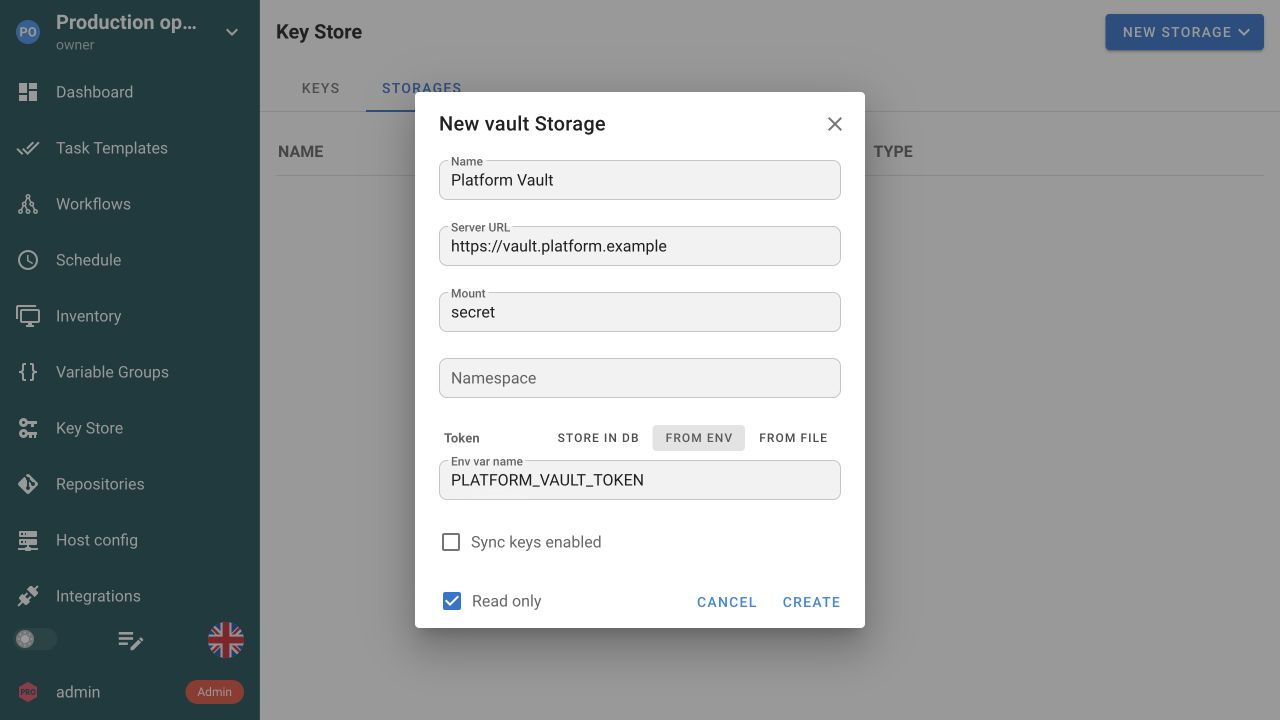
Connectez un coffre-fort externe avec son adresse et ses paramètres d’authentification. Choisissez un accès en lecture seule si Semaphore doit uniquement récupérer des secrets.
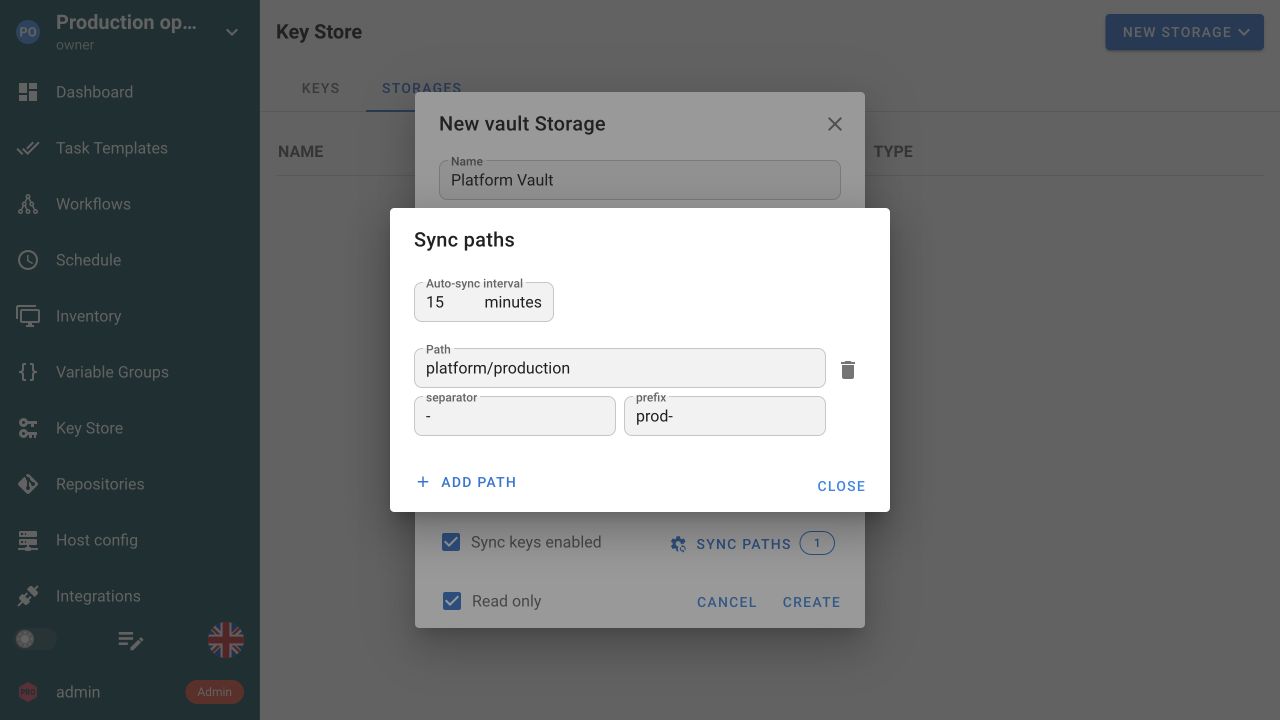
Sélectionnez les chemins distants à importer, définissez un préfixe de nom et choisissez l’intervalle de synchronisation automatique. Gardez les entrées importées du Key Store cohérentes avec leur source.
Utilisez les identifiants nécessaires au travail via ses références de dépôt, inventaire et Ansible Vault. Le modèle garde la configuration prête pour la prochaine exécution.
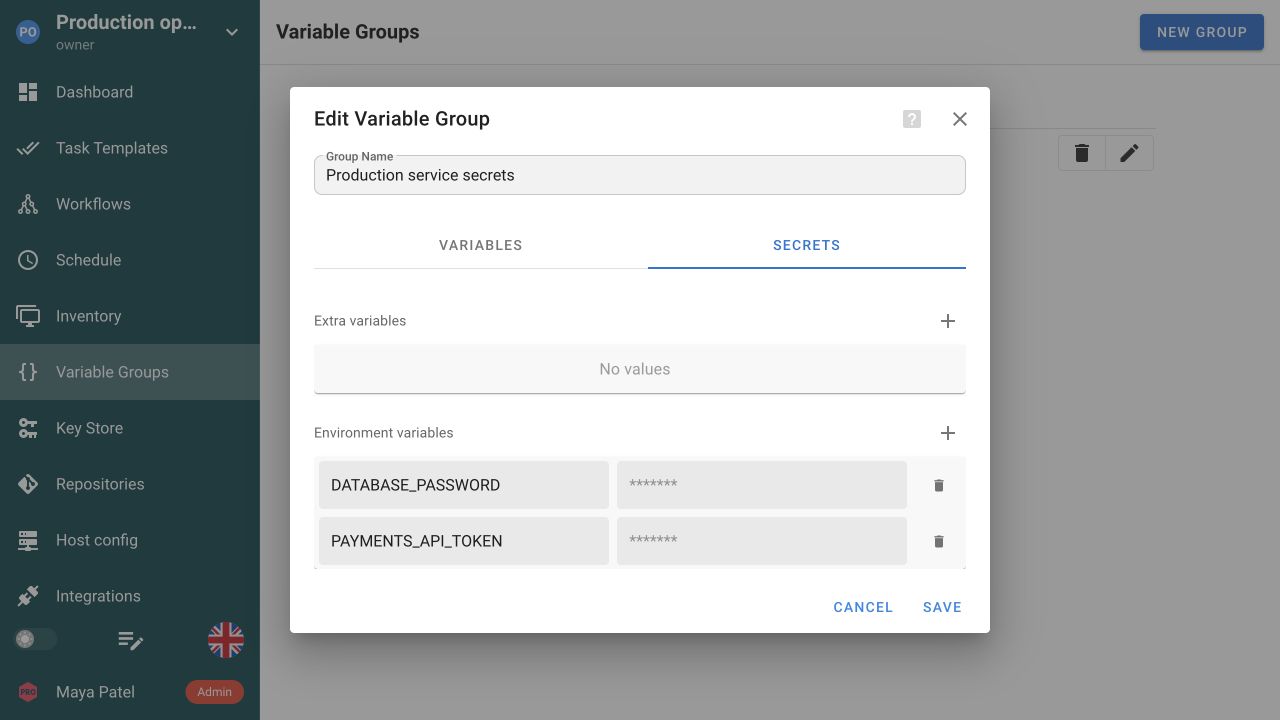
Conservez jetons API et mots de passe dans l’onglet Secrets du groupe. Associez le Variable Group aux Task Templates qui en ont besoin.
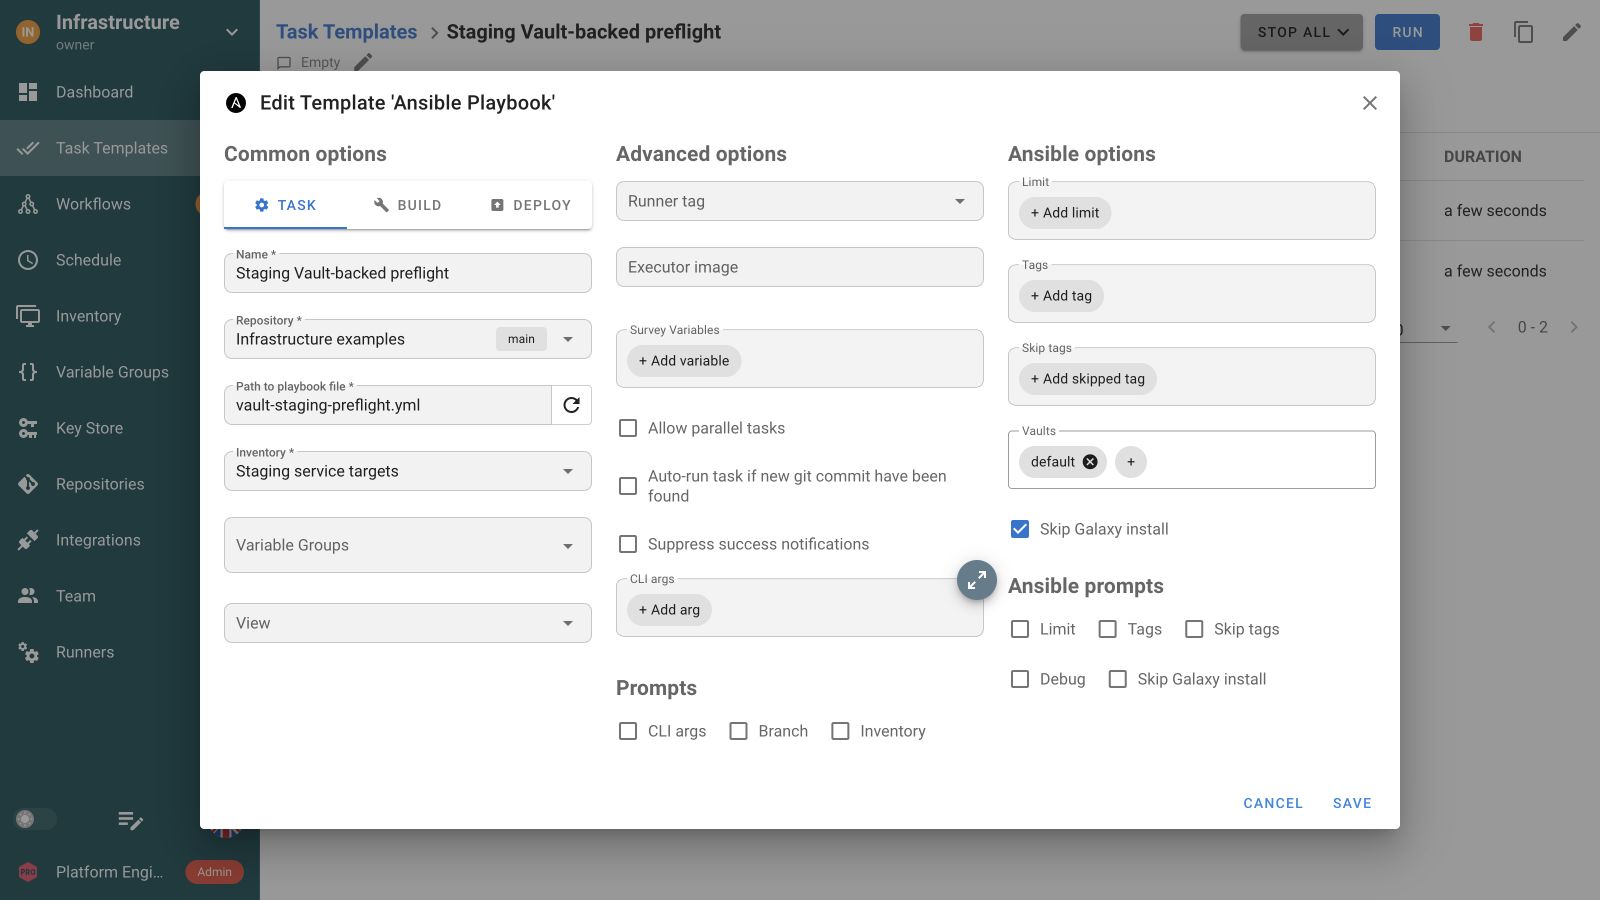
Le Key Store contient les types d’identifiants réellement nécessaires : clés SSH et connexions aux hôtes, accès aux dépôts Git privés, mots de passe sudo et Ansible Vault. Le modèle référence l’entrée ; les ingénieurs configurent et lisent un nom tandis que la valeur reste hors du dépôt et du formulaire de tâche. Les valeurs locales sont chiffrées en base lorsque le chiffrement des clés d’accès est configuré. Cette configuration et sa récupération font donc partie de la procédure de sauvegarde, pas d’un réglage facultatif.
Les sources d’environnement et de fichiers permettent à une entrée du Key Store de lire sa valeur sur le serveur Semaphore au besoin, au lieu d’en stocker une copie dans la base. Utilisez ce parcours lorsqu’un autre processus écrit déjà des identifiants actualisés sur l’hôte : après rotation de la source, la tâche suivante récupère la nouvelle valeur sans modifier de modèle. Le serveur Semaphore résout ces sources même avec un runner distant ; le fichier n’a donc pas besoin d’exister sur le runner. Les sources de fichiers respectent le répertoire de secrets configuré et le format JSON documenté ; les entrées SSH ou de connexion utilisent aussi cette enveloppe plutôt qu’un fichier de clé brut.
Les Variable Groups associent configuration partagée et valeurs secrètes. Référencez un identifiant stocké pour une entrée secrète plutôt que le dupliquer dans chaque travail. Transmettez le groupe à Ansible, Terraform, OpenTofu ou un script avec les noms de variables attendus par l’outil.
Référencez les secrets HashiCorp Vault ou OpenBao avec Pro. Enterprise ajoute des intégrations prises en charge comme AWS Secrets Manager, CyberArk et Devolutions Server. Gardez le secret dans son système propriétaire et utilisez la configuration documentée du fournisseur pour le rendre accessible à l’automatisation.
Bien stocker une valeur ne contrôle pas son utilisation par le code. Un playbook ou script peut écrire un secret dans sa sortie via une tâche de débogage, un argument ou une réponse API, et rien ne garantit que toutes ces valeurs soient retirées du journal. Utilisez les fonctions de l’outil, comme no_log d’Ansible, examinez échecs et réussites et traitez l’accès aux journaux et exports comme l’accès à tout leur contenu.
Les JWT de tâche fournissent une identité signée pour une exécution individuelle. Un service récepteur peut vérifier émetteur, audience et déclarations plutôt que partager un jeton durable avec chaque travail. Configurez la confiance des deux côtés ; les clés SSH, mots de passe et références de coffre-fort restent disponibles pour les systèmes qui en ont besoin.
Utilisez des identifiants nommés du Key Store pour dépôts privés, hôtes gérés et mots de passe Ansible Vault. Gardez code et configuration non sensible dans Git, tandis que le modèle référence les identifiants nécessaires. Une référence facilite réutilisation et rotation par rapport aux valeurs intégrées aux scripts. Elle ne remplace pas la protection du droit de modifier le code exécutable, puisque ce code utilise les accès fournis.
Non. Ansible Vault protège le contenu Ansible chiffré ; un Task Template peut utiliser un mot de passe Vault du Key Store Semaphore pour le déverrouiller. HashiCorp Vault est une option distincte de stockage externe Pro pour les secrets du Key Store. La vérification enregistrée de cette page montre le parcours du mot de passe Ansible Vault, pas une connexion à HashiCorp Vault. Évaluez ce stockage séparément avec un identifiant temporaire avant un usage opérationnel.
Les valeurs locales du Key Store utilisent le mécanisme de chiffrement des clés d’accès configuré pour leur stockage en base. Configurez et protégez correctement ce chiffrement et incluez ses conditions de récupération dans votre procédure de sauvegarde. Le chiffrement au repos est un élément de la conception : l’exécution autorisée doit encore utiliser l’identifiant. Protégez serveur, environnement d’exécution, accès administratif et journaux plutôt que de considérer une valeur chiffrée en base comme inaccessible à tout code ou ingénieur.
Les sources d’environnement et de fichiers documentées sont résolues par le serveur Semaphore lorsque la tâche a besoin de la clé, y compris avec un runner distant. Les fichiers doivent respecter le répertoire de secrets autorisé et le format documenté. Une tâche ultérieure peut récupérer une valeur renouvelée sans réécrire son modèle. Placer un fichier de clé brut sur le runner ne met pas en œuvre ce mécanisme serveur.
Oui. Pro prend en charge HashiCorp Vault et OpenBao comme sources externes. Enterprise ajoute d’autres intégrations de gestionnaires de secrets. Configurez le fournisseur et référencez les identifiants via le Key Store plutôt que d’enregistrer la valeur dans Git. Suivez le guide pour authentification et chemins, puis testez le travail avec les identifiants prévus.
Les modèles référencent des identifiants nommés plutôt que d’intégrer un mot de passe ou une clé dans chaque travail. Mettez à jour l’identifiant ou sa source, puis vérifiez les dépôts et inventaires qui le référencent. Testez une tâche représentative après rotation pour détecter les erreurs avant la prochaine exécution planifiée de production.
Ne comptez pas sur une garantie universelle de masquage. Un playbook ou script peut afficher des variables sensibles, arguments de commande ou réponses API. Choisissez délibérément les informations journalisées, utilisez les options de protection des secrets de l’outil et examinez des sorties d’échec représentatives aussi bien que les réussites. Restreignez l’accès aux journaux et exports selon leur contenu. Stocker une valeur de façon sûre ne contrôle pas à lui seul tout ce qu’affiche le code exécuté.
Oui. Nommez l’identifiant dans le Key Store et sélectionnez-le partout où dépôt, inventaire ou modèle nécessitent ce type. Les travaux référencent l’entrée configurée plutôt qu’une copie dans Git. Utilisez des identifiants séparés si les cibles nécessitent différentes identités. Voir les Task Templates.