
Collegare il repository Git
Usa GitHub, GitLab, Bitbucket o altro host Git via HTTPS o SSH. Seleziona ramo e file e aggiungi credenziali per repository privati.
Trasforma playbook e script in job nominati con destinazioni, credenziali e input già associati. Il team può eseguirli e controllarne chiaramente il risultato.
| Nome | Esegui | Stato |
|---|---|---|
Salva una volta la configurazione in un Task Template. Dai al team un job pronto anziché un’altra spiegazione di host, credenziali e opzioni di comando.
Consenti ai colleghi di eseguire il job senza modificarne l’impostazione.
Evita configurazioni manuali e comandi da ricordare.
Elimina aggiornamenti e rinnovi certificati dalla lista delle cose da fare.
Vedi chi ha eseguito cosa, quando e con quale risultato.
L’interfaccia era abbastanza chiara da far capire cosa accadeva anche a una persona non tecnica.

Salva playbook, repository, inventario e opzioni come job nominato.
Avvia il job salvato con Esegui. Aggiungi campi o Survey solo quando un tecnico deve fornire valori.
Esamina log, dettagli e risultati per ciascun host.
Le Survey Variables raccolgono valori variabili: ambiente, versione o riferimento di modifica. Mantieni il resto nel modello, pronto al prossimo avvio.
Survey Variables e campi di input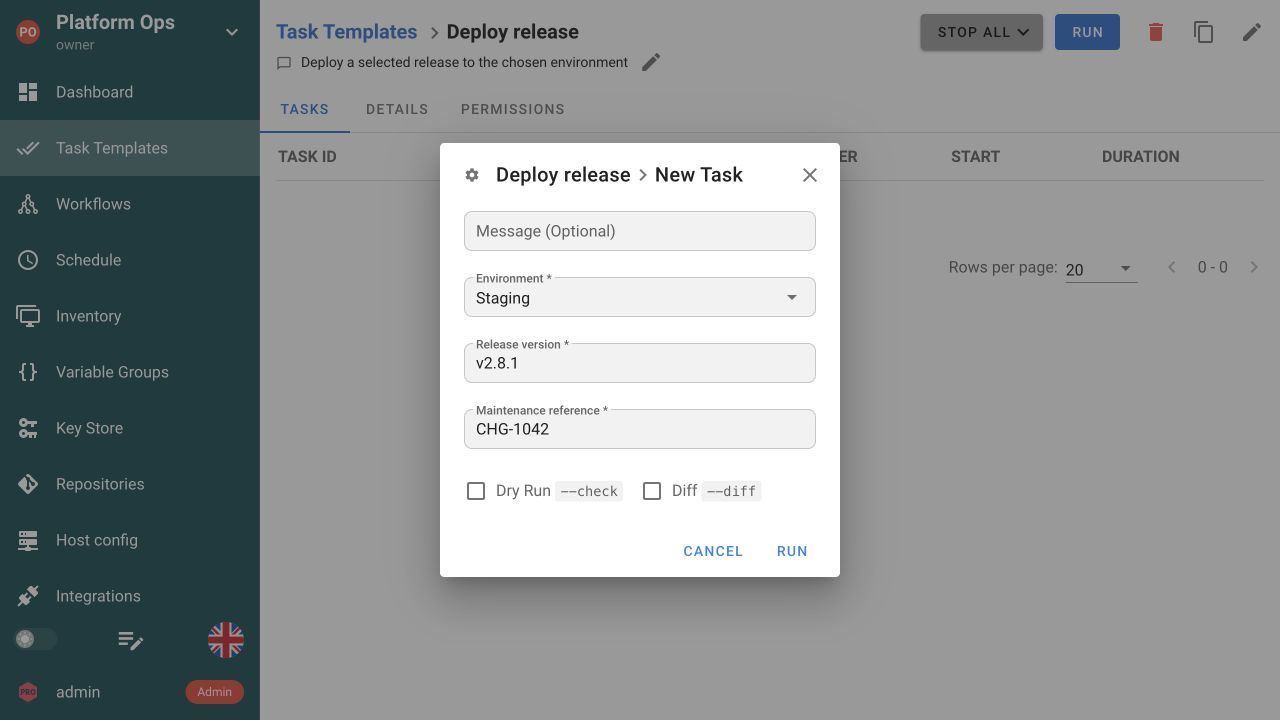
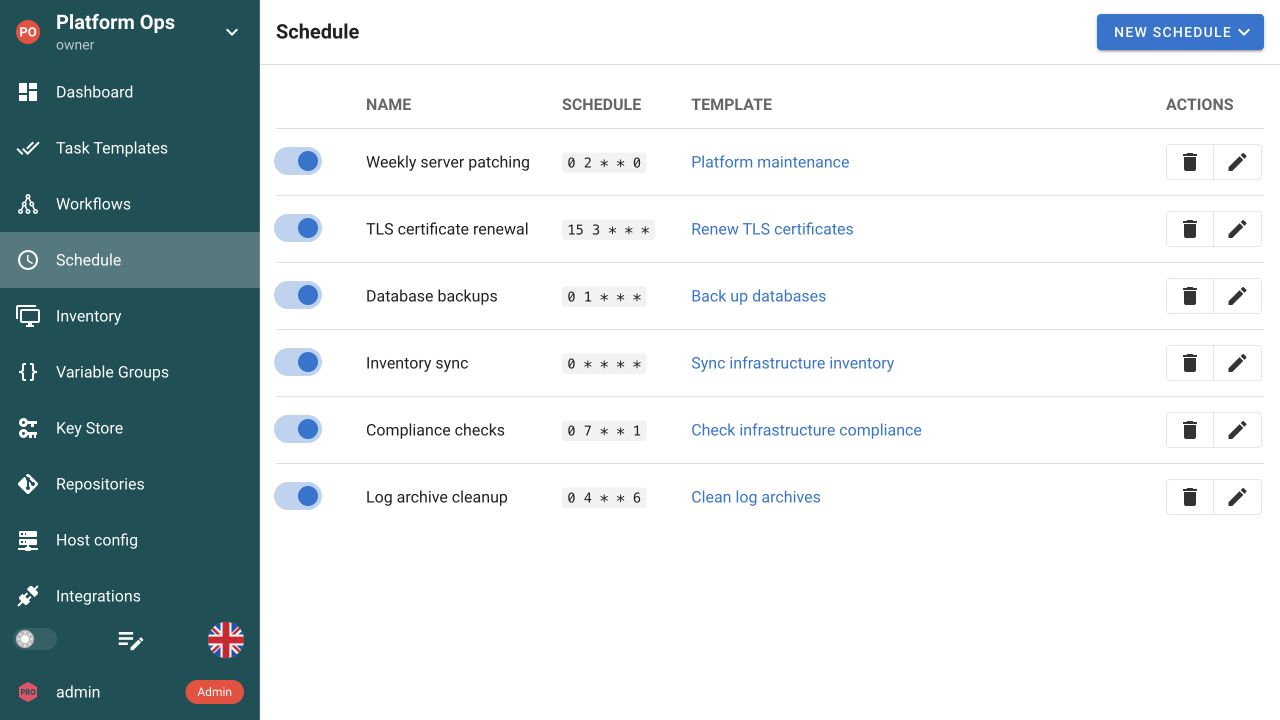
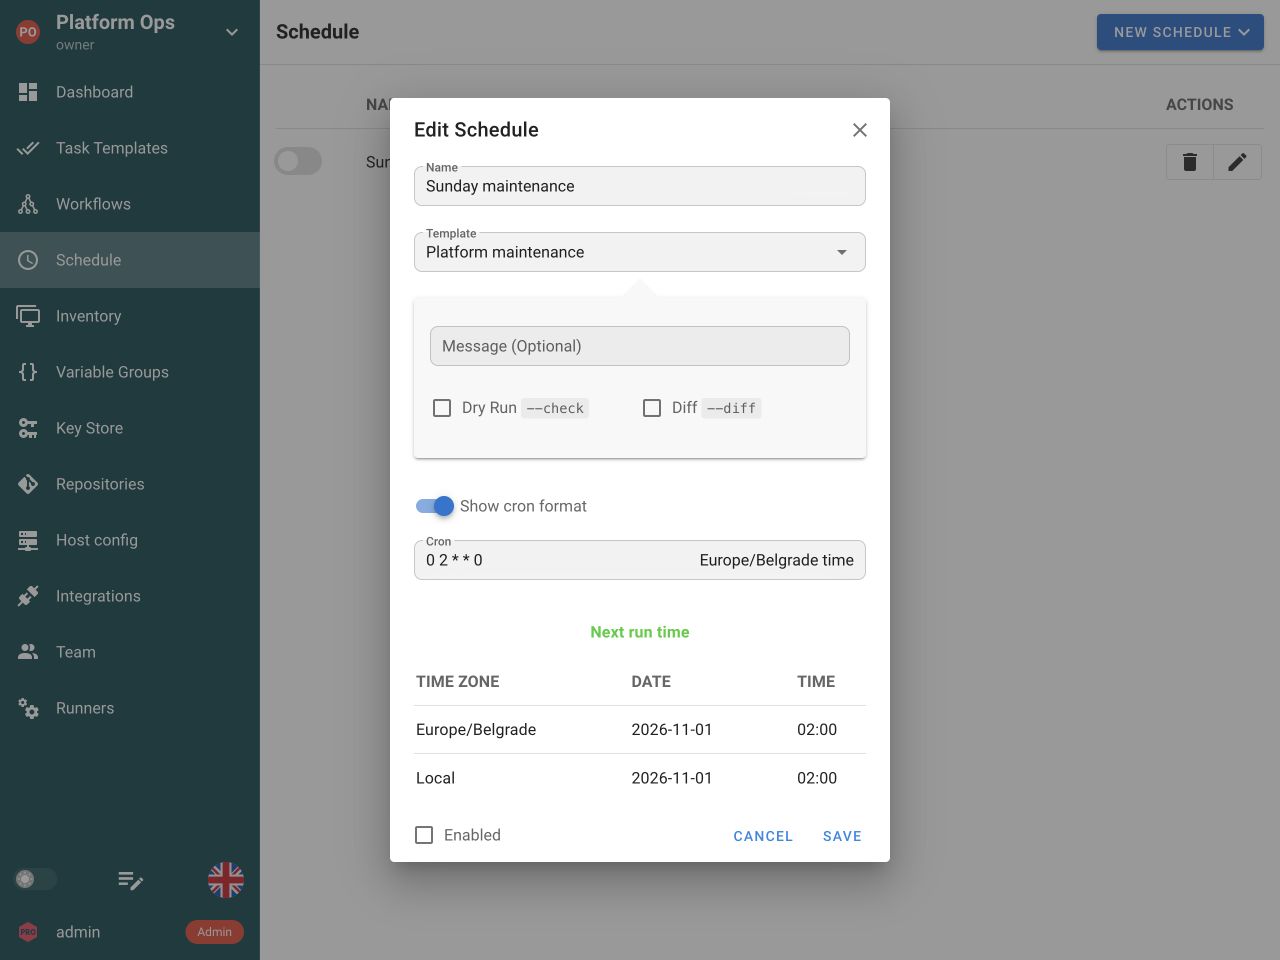
È facile perdere il controllo di una crontab personale. Pianifica un Task Template salvato per aggiornamenti, rinnovo dei certificati o controlli ricorrenti. Ogni ricorrenza crea un task distinto, con stato e output consultabili dal team.
Explore SchedulesInstalla Semaphore, collega l’automazione presente nel repository e dai al team un luogo condiviso per eseguirla.
Mantieni playbook, script e codice infrastrutturale. Aggiungi un modo condiviso per eseguirli.
Usa GitHub, GitLab, Bitbucket o altro host Git via HTTPS o SSH. Seleziona ramo e file e aggiungi credenziali per repository privati.
Ogni strumento conserva impostazioni, ambiente e output propri.

Usa un tag per inviare task ai runner di progetto corrispondenti in Pro con rete e strumenti richiesti.
Runner di progettoSostituisci l’immagine predefinita del job per un runner Docker in Pro o Kubernetes in Enterprise. Fissa la toolchain richiesta dal modello. L’esecuzione locale ignora questo campo.
Configurazione dell’immagine executor
Instrada job per tag e scegli un’immagine Docker per modello. L’esecuzione Kubernetes è disponibile in Enterprise.
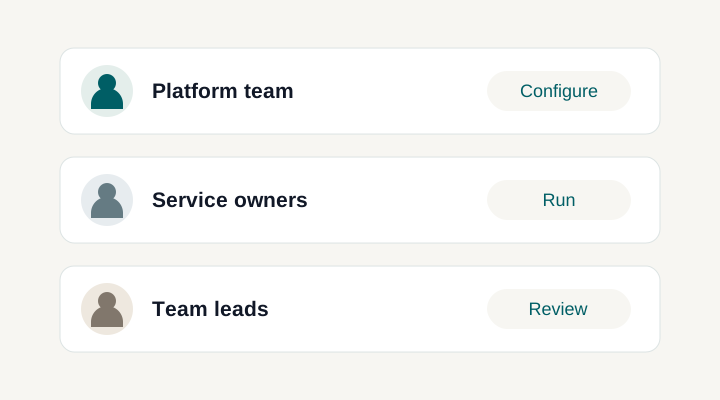
Fornisci ai tecnici un job nominato con pulsante Esegui e input necessari. Ruoli e permessi di progetto determinano chi può eseguirlo e modificarne la definizione. Ogni esecuzione mantiene stato e output propri.
Usa playbook, configurazioni e script da GitHub, GitLab, Bitbucket o host compatibili. Collegati via HTTPS o SSH, configura ramo e directory e mantieni la revisione nel flusso Git esistente.
Associa l’inventario che definisce host e gruppi. Conserva le credenziali nel Key Store e abilita il campo di limite Ansible quando i tecnici devono selezionare un sottoinsieme delle destinazioni.
I Variable Groups conservano configurazione riutilizzabile. I campi integrati espongono ramo, tag o limite host. Le Survey Variables raccolgono valori personalizzati senza ricostruire il job.
Usa modelli Build per assegnare versioni e Deploy per scegliere build riuscite. L’automazione crea, conserva e recupera artefatti; Semaphore mantiene il passaggio versionato tra i due job.
Esegui sul server Semaphore o su un runner configurato con accesso alle destinazioni. Prepara lì collection Ansible, pacchetti Python e altre dipendenze. Gli executor Docker e Kubernetes possono fornire la toolchain tramite un’immagine.
Abilita l’esecuzione automatica per controllare nuovi commit all’intervallo configurato e avviare il modello quando ci sono modifiche. Mantieni revisione e approvazione del codice nel flusso Git.
Scegli se un modello può eseguire task in parallelo. Configura le notifiche del team e sopprimi i successi dei job ricorrenti quando servono solo segnalazioni di errore.
Sì. Collega il repository Git, seleziona il playbook Ansible e associa inventario e credenziali a un Task Template. Le esecuzioni successive riusano la configurazione. Mantieni ruoli e collection e assicurati che server o runner abbiano le dipendenze necessarie. Scopri l’automazione Ansible.
I Task Template supportano Ansible, Terraform, OpenTofu, Terragrunt, Bash, PowerShell e Python. Ogni modello usa campi e modalità del proprio strumento. Mantieni il codice in Git e offri un avvio condiviso. L’ambiente richiede comunque strumenti, pacchetti e rete necessari.
Sì. Usa ruoli e permessi per separare esecuzione e modifica della definizione nel progetto. Un collega avvia il job con gli input esposti, mentre repository, inventario e credenziali restano nel modello. Scopri il controllo degli accessi.
Sì. Aggiungi Survey Variables per valori personalizzati come ambiente, versione o riferimento di manutenzione. I campi integrati espongono opzioni come limite host Ansible o sostituzione del ramo. I tecnici compilano gli input consentiti senza modificare il modello. Vedi il modulo Survey.
Sì. Parti da un Task Template funzionante e aggiungi una pianificazione cron o un intervallo predefinito. Il codice esegue aggiornamenti, backup o rinnovi; Semaphore avvia all’orario configurato. Ogni ricorrenza ha stato e output propri. Scopri le pianificazioni.
Apri la cronologia del modello per esaminare esecuzioni, autore, inizio, stato e output con eventuali errori. Analizza l’esecuzione anziché affidarti al messaggio che qualcuno ha premuto Esegui. Anche le pianificate appaiono come task. Scopri la cronologia.
Sì. La REST API avvia Task Template e un webhook configurato può attivarli da eventi. Riusa la configurazione invece di duplicarla in ogni servizio. Abilita i campi appropriati per le sostituzioni supportate all’avvio. Scopri API e webhook.
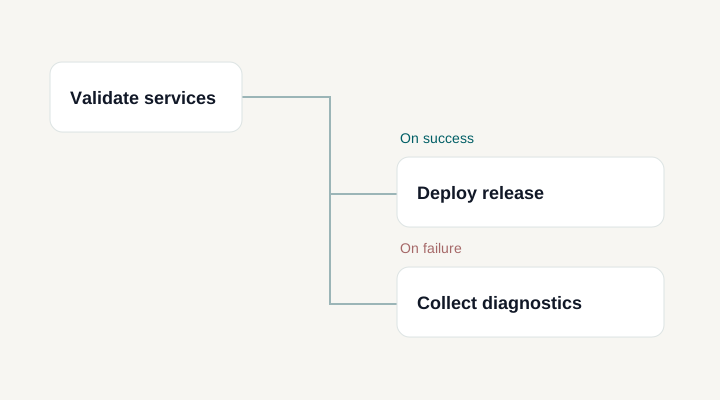
Sì. I workflow collegano Task Template in operazioni più ampie con successi, errori, approvazioni e ritardi. Ogni task conserva configurazione e output. Usali quando la procedura richiede coordinamento o decisioni umane tra job. Scopri i workflow.
In Pro un tag instrada task a runner di progetto corrispondenti vicini ai sistemi. Un modello può sostituire l’immagine predefinita per Docker in Pro o Kubernetes in Enterprise. Il campo immagine non vale per l’esecuzione locale. Scopri i runner.
Puoi mantenere playbook e ruoli in Git. Ricrea il contesto in Semaphore: repository, inventari, credenziali, gruppi e Task Template. È una migrazione di configurazione, non un’importazione AWX automatica. Verifica versioni, collection, campi e accessi dei runner prima della delega. Confronta Semaphore UI e AWX.


